Clase 1 · Introducción y repaso de estadística
Contenido oficial de la semana
Esta página reproduce íntegras y en orden las diapositivas de la semana 1 (sem1/).
Cátedra del viernes: Parte 1 (clase1.tex). Ayudantía: Partes 2 y 3
(repaso_ayudantia.tex y repaso_estadistica.tex), que se ven otro día. Los bloques
Interactivo, los casos y las preguntas de autoevaluación son material adicional para
estudiar; las soluciones de los ejemplos aparecen plegadas para que intentes resolverlos antes.
Cómo estudiar esta clase
La clase está ordenada en 11 temas. Cada tema parte con una pregunta guía, sigue con las láminas y los simuladores, y termina con ✍️ preguntas de selección múltiple (cada alternativa incorrecta explica por qué no lo es) y, en casi todos, un 🧪 ejercicio de R que puedes editar y ejecutar aquí mismo, sin instalar nada. Los 9 ejercicios de R en un solo archivo: 📥 clase1.R.
🎯 Objetivos de la sesión
Cátedra (viernes)
- Entender qué es la econometría y qué tipo de preguntas permite responder.
- Distinguir correlación de causalidad y el rol del supuesto ceteris paribus.
- Reconocer los tipos de datos y los métodos de muestreo.
Ayudantía
- Repasar estadística descriptiva (localización, dispersión, histograma y boxplot) e inferencial (TCL e intervalos de confianza para medias, proporciones y diferencias de medias).
🗓️ Agenda de la cátedra (viernes 18:40 – 21:25)
Haz clic en un tema para ir directo a él.
- 18:40🎓 Presentación del curso: programa, evaluaciones, cátedra + ayudantía y trabajo práctico
- 19:001¿Qué es la econometría?Parte 1 · láminas 1–3 · ✍️ 2 preguntas
- 19:252Correlación no es causalidadParte 1 · láminas 4–6 · ✍️ 2 preguntas · 🧪 R
- 19:55☕ Receso
- 20:053La econometría en acciónParte 1 · lámina 7 · ✍️ 2 preguntas
- 20:254Tipos de datosParte 1 · láminas 8–11 · ✍️ 2 preguntas · 🧪 R
- 20:505Población, muestra y parámetrosParte 1 · láminas 12–15 · ✍️ 2 preguntas · 🧪 R
- 21:006Métodos de muestreoParte 1 · láminas 16–19 · ✍️ 3 preguntas · 🧪 R
- 21:157Estadística descriptiva e inferencialParte 1 · lámina 20 · ✍️ 2 preguntas · 🧪 R
- 21:25✅ Ideas clave, autoevaluación y cierre
📘 Ayudantía · se trabaja otro día de la semana, no en la cátedra del viernes
- 8Estadística descriptivaParte 2 · Ayudantía · láminas 1–10 · ✍️ 2 preguntas · 🧪 R
- 9TCL e intervalos de confianza para la mediaParte 3 · Ayudantía · láminas 1–14 · ✍️ 2 preguntas · 🧪 R
- 10Intervalos de confianza para proporcionesParte 3 · Ayudantía · láminas 15–24 · ✍️ 2 preguntas · 🧪 R
- 11Intervalos para la diferencia de mediasParte 3 · Ayudantía · láminas 25–34 · ✍️ 2 preguntas · 🧪 R
Introducción a la econometría
📄 Diapositivas: sem1/clase1.tex · 20 láminas
¿Qué es la econometría?
¿Qué tipo de preguntas podemos responder combinando teoría económica, estadística y datos?
¿Qué es econometría?
-
Es una disciplina que emplea la teoría económica y métodos estadísticos para contrastar distintas teorías, pronosticar variables y evaluar políticas públicas utilizando bases de datos.
-
Es una aplicación del metodo científico en economía. Nos permite refutar hipótesis económicas.
-
Nos permite contestar preguntas como por ejemplo:
-
Cuál es la brecha salarial por género?
-
Cuál es el efecto de haber completado la universidad en el salario?
-
Econometría moderna
La econometría moderna se enfoca en contestar 3 tipos de preguntas:
-
Estimar como la esperanza condicional de una variable depende de otra.
-
Estimar el impacto causal de una variable sobre la otra.
-
Predecir el comportamento de una variable hacia el futuro.
Método econométrico
-
Definir objetivo: qué quiero estudiar?
-
Estructura:
-
Modelo Económico: modelos que explican el comportamiento de una variable económica en función de otras.
\(Y = f (x_1; x_2; ...; x_k)\)
Ejemplo 1: Función de producción \(Y = AK^{\alpha}L^{\beta}\)
Ejemplo 2: Retornos educación
salario = f (educ; experiencia; ingfamiliar ; habilidad) -
Modelo econométrico: permite cuantificar, contrastar y evaluar el modelo económico.
-
Especificar la funcion f (:).
-
Las variables económicas son aleatorias por lo que lo incorporamos con un termino de error:
\(y = f (x_1; x_2;...; x_k) + u\) -
Los datos.
-
-
✍️ Practica · Tema 1
¿Cuál de estas preguntas es de predicción, uno de los tres tipos de la lámina 2?
✅ Lámina 2: la econometría moderna estima esperanzas condicionales, impactos causales y predicciones.
En y = f(x₁, …, xₖ) + u, ¿por qué aparece el término u?
✅ Lámina 3: el modelo econométrico agrega un término de error al modelo económico.
Correlación no es causalidad
Si dos variables se mueven juntas, ¿una causa la otra?
Causalidad y correlación
Correlación no es causalidad
-
Muchas veces nos interesa conocer el efecto causal de una variable sobre otra.
-
El concepto ceteris paribus es clave para la causalidad: efecto de X sobre Y manteniendo todos los demas factores relevantes constantes. Muy difícil en la práctica en ciencias sociales.
-
Vamos a ver en el curso los supuestos necesarios y técnicas para hacerlo.
Correlación espuria: existe una relación matemática pero los factores no presentan una relación lógica.
Ejemplo
-
Información: En una base de individuos de 35 años de Chile, encuentro que las personas que terminaron la universidad ganan 30% más que las que no la terminaron.
-
Pregunta: De lo anterior, puedo concluir que ir a la universidad causa un aumento del ingreso de los individuos?
Respuesta
No puedo concluir eso.
-
Ir a la universidad está asociado con un montón de otras características que tambien afectan ingreso.
-
Por ejemplo, la habilidad, el ingreso de los padres, etc.
✍️ Practica · Tema 2
En los días con más venta de helados hay más ataques de tiburón. ¿Qué lo explica mejor?
✅ El calor lleva a comprar helados y a bañarse en el mar. Manteniendo la temperatura constante (ceteris paribus), la relación desaparece.
Las personas de 35 años que terminaron la universidad ganan 30% más. ¿Qué haría falta para afirmar que la universidad causa ese 30%?
✅ Es la respuesta de la lámina 6: ir a la universidad está asociado con otras características que también afectan el ingreso.
🧪 Practica en R · Helados, tiburones y temperatura
Simula 200 días en que la temperatura aumenta las ventas de helados y los ataques de tiburón, pero los helados no afectan los ataques. Compara la regresión con y sin la temperatura.
# Un día caluroso hace que se vendan más helados Y que más gente se bañe en el mar
set.seed(1)
dias        <- 200
temperatura <- runif(dias, 10, 35)
helados     <- 20 + 3 * temperatura + rnorm(dias, sd = 8)
ataques     <- 0.1 * temperatura + rnorm(dias, sd = 0.5)  # sin helados

cor(helados, ataques)                        # correlación alta…
coef(lm(ataques ~ helados))["helados"]       # …y pendiente positiva
coef(lm(ataques ~ helados + temperatura))    # con temperatura fija: ≈ 0

plot(helados, ataques, pch = 19, col = "steelblue",
     main = "¿Los helados provocan ataques de tiburón?")
🎯 Reto: cambia 0.1 * temperatura por 0 * temperatura. ¿Qué pasa con la correlación entre helados y ataques?
La econometría en acción
¿Cómo ayuda la econometría a decidir qué políticas funcionan?
Econometría como herramienta aplicada
-
Pregunta: como solucionamos problemas de worms intestinales en Africa?
Miguel y Kremer (2004), Worms: Identifying Impacts on Education and Health in the Presence of Treatment Externalities: Encuentran que repartir pildoras en colegios, mejora la salud, reduce el ausentismo educacional no solo de los tratados sino también de sus vecinos. Gracias a estos estudios la iniciativa deworming the world recauda billones de dólares para esta política. -
Pregunta: las consultoras de management pueden mejorar la productividad de las firmas?
Bloom et al. (2017) Increasing Firm Productivity through Management Consulting Services in India: Muestra que si y lo cuantifica.
✍️ Practica · Tema 3
Según Miguel y Kremer (2004), ¿qué pasó al repartir pastillas antiparasitarias en colegios?
✅ Por eso el título habla de Treatment Externalities: el tratamiento también beneficia a quienes no lo recibieron.
¿Qué tienen en común el estudio de Worms y el de consultorías en India (Bloom et al.)?
✅ Son experimentos aleatorizados: la herramienta que veremos en la Clase 3 para eliminar el sesgo de selección.
Tipos de datos
¿De dónde vienen los datos y qué forma tienen?
Tipos de Datos
-
Experimentales: el investigador asigna en forma aleatoria la exposición.
-
Pseudo-experimental: el investigador controla la exposición pero no asigna en forma aleatoria.
-
Observacional (o no-experimental): el investigador no controla la exposición, depende de variables que el no controla.
Rara vez usa datos experimentales extremadamente caros, problemas éticos.
Corte transversal: Muestra de individuos, hogares, empresas, regiones, países, etc., recolectados en un tiempo dado. A veces el estudio no se realiza exactamente en el mismo periodo de tiempo para todos las unidades evaluadas, pero diferencias temporales menores se ignoran. Se asume que los datos fueron obtenidos por muestreo aleatorio (random sampling) desde la población subyacente.
Series de tiempo: Observaciones de una o más variables en el tiempo. Ej. Precios de acciones, dólar, IPC, ventas de automóviles, etc. Eventos pasados influencian eventos futuros. Rezagos en el comportamiento son prevalentes en ciencias sociales. Tiempo es una dimensión importante en datos de series de tiempo. Frecuencia \(\Delta\) tiempo=1, día, año, semestre, trimestre, etc. A diferencia de datos de corte transversal, datos de series de tiempo no pueden asumirse independientes.
Datos longitudinales o de panel: Consiste en una serie de tiempo para cada miembro del set de datos. Ejemplo: 10 años de datos de salario, educación y empleo sobre un set de individuos. Diferencias con los anteriores es que los mismos individuos, firmas o países, son seguidos por varios años.
Varias ventajas: Control de ciertas características no observadas de individuos, firmas, etc. Facilita estudios de causa-efecto (inferencia causal). Permite estudiar los efectos del rezago en el comportamiento o resultado.
✍️ Practica · Tema 4
Tienes el PIB trimestral de Chile, Perú y Colombia entre 2000 y 2024. ¿Qué tipo de datos son?
✅ Es un panel: las mismas unidades (3 países) observadas en muchos períodos.
Una empresa sortea qué sucursales reciben un nuevo sistema de incentivos y compara las ventas. ¿Qué tipo de datos genera?
✅ La exposición la asigna el investigador en forma aleatoria: es un experimento (lámina 8).
🧪 Practica en R · Tres formas de datos
Arma un ejemplo pequeño de cada tipo de datos de las láminas 9 a 11 y fíjate en qué cambia: las unidades, los períodos o ambos.
set.seed(4)
# Corte transversal: muchas unidades en un mismo momento
corte <- data.frame(persona = c("Ana", "Beto", "Carla"),
                    salario = c(850, 620, 1100), anio = 2024)
# Serie de tiempo: una unidad a lo largo del tiempo
serie <- data.frame(anio = 2020:2024,
                    dolar = c(792, 759, 873, 840, 944))  # promedio anual aprox.
# Panel: las MISMAS unidades en varios momentos
panel <- expand.grid(persona = c("Ana", "Beto", "Carla"), anio = 2022:2024)
panel$salario <- round(700 + 60 * (panel$anio - 2022) + rnorm(9, sd = 40))

corte
serie
panel
table(panel$persona)   # cada persona aparece una vez por año
🎯 Reto: agrega el año 2025 al panel (cambia 2022:2024 por 2022:2025 y 9 por 12). ¿Cuántas filas tiene ahora?
Población, muestra y parámetros
¿Cómo podemos conocer a toda una población mirando solo una parte?
Muestreo
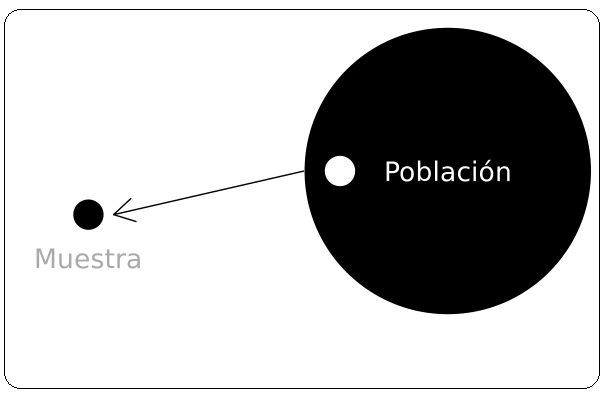
Los datos experimentales son obtenidos sobre conjuntos de individuos u objetos, sobre los cuales se quiere conocer algunas características.
Llamaremos unidad de observación a estos individuos y la totalidad de estas unidades de observación se denomina población.
El Muestreo es la disciplina que trata con el conjunto de métodos, técnicas y procedimientos para tomar u obtener una muestra particular de la población a efecto de realizar inferencias a partir de la misma.
Se dice que una muestra es representativa de una población si toda unidad de observación podrá aparecer en la muestra, y esto con una probabilidad conocida.
¿Por qué muestrear la población?
-
Imposibilidad física de chequear todos los ítems en la población.
-
El costo de estudiar todos los elementos en la población.
-
Los resultados del muestreo son normalmente adecuados.
Objetivos del muestreo
Estimar los parámetros de la población.
-
Variable: lo que se desea medir en la muestra. Ej. Nivel de educación, nivel de ingresos, etc.
-
Parámetros: valor numérico que describe una característica de una población completa. Promedio, desviación estándar, betas, etc.
-
Estadístico: calculado sobre la muestra.
-
Los parámetros normalmente son desconocidos, se estiman a través del estadístico.
✍️ Practica · Tema 5
El ingreso promedio de todos los hogares de Chile es un…
✅ Lámina 15: los parámetros describen a la población y normalmente se estiman con estadísticos muestrales.
Una fábrica de ampolletas quiere saber cuántas horas duran. ¿Por qué no las prueba todas?
✅ Lámina 14: imposibilidad física, costo y resultados que normalmente son adecuados.
🧪 Practica en R · Muestra grande pero sesgada
Una población de 100 000 votantes. Compara una muestra enorme tomada solo entre quienes tienen teléfono con una pequeña muestra aleatoria.
set.seed(1936)
N <- 100000
# Población: quienes tienen teléfono (más ricos) prefieren más al candidato A
telefono <- rbinom(N, 1, 0.35)
vota_A   <- rbinom(N, 1, ifelse(telefono == 1, 0.60, 0.30))
mean(vota_A)                 # parámetro (en la práctica, desconocido)

grande_sesgada <- sample(which(telefono == 1), 20000)  # solo con teléfono
pequena_azar   <- sample(N, 1000)                      # aleatoria simple
c(sesgada_n20000 = mean(vota_A[grande_sesgada]),
  azar_n1000     = mean(vota_A[pequena_azar]))
🎯 Reto: aumenta la muestra sesgada de 20000 a 30000. ¿Se acerca al parámetro?
Métodos de muestreo
¿Cuál es la mejor manera de elegir la muestra?
Muestreo aleatorio
-
Muestreo aleatorio simple: muestra seleccionada de manera que cada elemento o individuo de la población tenga las mismas posibilidades de que se le incluya.
-
Muestreo aleatorio sistemático: Los elementos o individuos de la población se ordenan de alguna manera. Se selecciona un punto aleatorio de inicio y posteriormente se elige cada k-esimo miembro de la población. A nivel técnico, el muestreo sistemático no crea una muestra verdaderamente aleatoria. Sólo la selección del primer elemento de muestreo sistemático es una selección de probabilidad. Una vez que el primer elemento es seleccionado, algunos de los elementos tendrán una probabilidad cero de selección.
-
Muestreo aleatorio estratificado: La población se divide en subgrupos denominados estratos y se selecciona al azar una muestra de cada estrato.
-
Muestreo por conglomerados (cluster): La población se divide en conglomerados a partir de límites geográficos o de otra clase. Luego se seleccionan los conglomerados al azar y se toma una muestra aleatoria con elementos de cada grupo.
Muestreo Estratificado vs. Muestreo por Conglomerados
Muestreo Estratificado
Cada estrato es homogéneo. Se selecciona muestra dentro de cada uno.
Muestreo por Conglomerados
Cada conglomerado es heterogéneo. Se seleccionan grupos completos.
Comparación Clave
-
Estratos: Internamente homogéneos. Se muestrea dentro de cada grupo.
-
Conglomerados: Internamente heterogéneos. Se seleccionan grupos enteros.
Muestreo no probabilístico
- En muestreo no probabilístico inclusión en la muestra es basada en el juicio de la persona que selecciona los individuos o elementos.
✍️ Practica · Tema 6
Sorteas uno de los primeros 10 clientes de una lista y luego eliges a cada décimo cliente. ¿Qué método es?
✅ Lámina 16: se ordena la población, se elige un inicio al azar y luego cada k-ésimo elemento.
Quieres estimar el ingreso promedio en Santiago. Las comunas son muy distintas entre sí, pero bastante homogéneas por dentro. ¿Qué método es más preciso para un mismo n?
✅ Grupos homogéneos por dentro y distintos entre sí funcionan como estratos: muestrear en todos reduce la varianza (lámina 18).
El Literary Digest encuestó a más de 2 millones de personas y se equivocó. ¿Por qué?
✅ Lámina 13: una muestra es representativa si toda unidad puede aparecer con una probabilidad conocida.
🧪 Practica en R · Estratificado contra aleatorio simple
Simula tres comunas con ingresos muy distintos y compara 2 000 muestras de cada método: ¿cuál se equivoca menos?
set.seed(18)
# Ingresos en 3 comunas muy distintas entre sí, pero parecidas por dentro
comuna  <- rep(c("A", "B", "C"), each = 2000)
ingreso <- c(rnorm(2000, 500, 50), rnorm(2000, 900, 60),
             rnorm(2000, 1600, 80))
mean(ingreso)                                  # parámetro

simple <- replicate(2000, mean(sample(ingreso, 60)))
estratificado <- replicate(2000, mean(c(
  sample(ingreso[comuna == "A"], 20),
  sample(ingreso[comuna == "B"], 20),
  sample(ingreso[comuna == "C"], 20))))
c(simple = sd(simple), estratificado = sd(estratificado))  # error típico

boxplot(list(Simple = simple, Estratificado = estratificado),
        ylab = "Promedio estimado (n = 60)")
abline(h = mean(ingreso), lty = 2)
🎯 Reto: haz que las comunas se parezcan (cambia 500 y 1600 por 900). ¿Sigue ganando el estratificado?
Estadística descriptiva e inferencial
¿Cuándo una conclusión vale solo para los datos y cuándo para toda la población?
Estadística descriptiva e inferencial
-
Estadística Descriptiva o Deductiva.
Si al analizar una muestra sólo se obtenemos conclusiones válidas para la muestra sin que se puedan o se requieran generalizar sus resultados para toda la población.
-
Estadística Inductiva o Inferencial.
A partir de una muestra, podemos inferir conclusiones estadísticamente válidas para todo la población.
✍️ Practica · Tema 7
Un profesor calcula el promedio de notas de su curso para informárselo al curso. ¿Qué estadística usa?
✅ Lámina 20: la estadística descriptiva saca conclusiones válidas solo para la muestra analizada.
Con una encuesta a 1 000 personas estimas la tasa de desempleo del país y su intervalo de confianza. ¿Qué estadística usas?
✅ Generalizar a la población con un margen de error es inferencia: es lo que repasa la ayudantía.
🧪 Practica en R · Describir e inferir
Con 36 meses de ventas, primero describe la muestra y luego infiere la media poblacional, como en el ejemplo de la ayudantía.
set.seed(7)
ventas <- round(rnorm(36, mean = 200, sd = 60))   # 36 meses de ventas

# Descriptiva: resume ESTA muestra
summary(ventas)
sd(ventas)

# Inferencial: dice algo de la POBLACIÓN (la media μ, que no conocemos)
mean(ventas) + c(-1, 1) * 1.96 * 60 / sqrt(36)    # IC 95%, σ = 60 conocido
🎯 Reto: cambia los dos 36 por 144. ¿Qué pasa con el ancho del intervalo?
Repaso de estadística descriptiva
📄 Diapositivas: sem1/repaso_ayudantia.tex · 10 láminas
Material de ayudantía
Las Partes 2 y 3 no se ven en la cátedra del viernes: se trabajan en la ayudantía de la semana.
Estadística descriptiva
¿Cómo resumir muchos datos en pocos números y gráficos?
Ramas de la Estadística
La Estadística se divide en dos áreas:
-
Estadística Descriptiva: se emplea como una primera aproximación a los datos. Utiliza tablas y gráficos para resumir la información disponible.
-
Estadística Inferencial: va un poco más allá. A partir de los datos desarrolla mecanismos de decisión parar determinar si los datos sustentan o no una hipótesis. Permite hacer predicciones.
Estadística Descriptiva
-
Los estadísticos son funciones de los datos de una muestra:
\[ f(X_1,....,X_n) \] -
gráficos: histogramas, gráficos de caja
-
tablas: de frecuencia, contingencia, etc.
Estadísticos de Localización Central
-
Media empírica o promedio:
\[ \bar{X}=\frac{1}{n}\sum_{i=1}^n X_i \] -
Mediana: Si se tiene una muestra \(X_1,...,X_n\), se ordenan los datos de menor a mayor: \(X_{(1)},...X_{(n)}\). La mediana es la observación que queda en el medio.
\[ Med(X_1,....,X_n)=\left\{ \begin{array}{ll} X_{(\frac{n+1}{2})}, & \hbox{si $n$ es impar} \\ \frac{X_{(n/2)}+X_{(n/2+1)}}{2}, & \hbox{si $n$ es par} \end{array} \right. \]
-
Suponiendo que se tienen 13 datos (caso de \(n\) impar):
\[ X_{(1)},......,\underbrace{X_{(7)}}_\text{mediana},......,X_{(13)} \] -
Suponiendo que se tienen 12 datos (caso de \(n\) par):
\[ X_{(1)},......,\underbrace{X_{(6)},X_{(7)}}_\text{mediana$=\frac{X_{(6)}+X_{(7)}}{2}$},......,X_{(12)} \]
Estadísticos de Localización
-
Un percentil es una medida estadística que indica la posición de un dato dentro de un conjunto de observaciones, dividiendo los datos en 100 partes iguales.
-
Los percentiles más empleados son: \(P_{25}\), \(P_{50}=Mediana\), \(P_{75}\) y se conocen como cuartiles ya que dividen a los datos en 4 partes (se suelen nombrar \(q_1\), \(q_2\) y \(q_3\)).
-
También existen los quintiles y deciles, según se dividan a los datos en 5 o 10 partes.
Estadísticos de dispersión
-
El rango intercuartílico: se define como:
\[ RIQ(X_1,...,X_n)=q_3-q_1 \] -
La varianza muestral o empírica se define como:
\[ Var(X_1,...,X_n)=\frac{\sum_{i=1}^n (X_i-\bar{X})^2}{n-1} \]
-
La desviación estándar muestral o empírico es la raíz cuadrada de la varianza, es decir:
\[ S(X_1,...,X_n)=\sqrt{\frac{\sum_{i=1}^n (X_i-\bar{X})^2}{n-1}} \]
Histograma
El histograma resume los datos dentro de algunos rangos y se cuenta el número de observaciones dentro de cada rango.
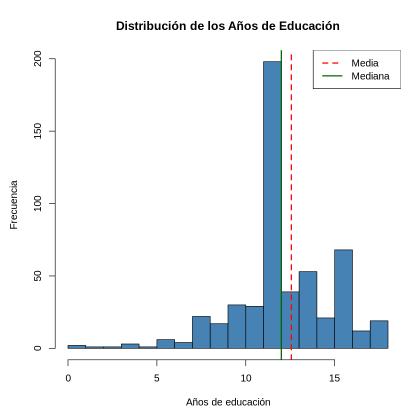
Gráfico de caja - Boxplot
-
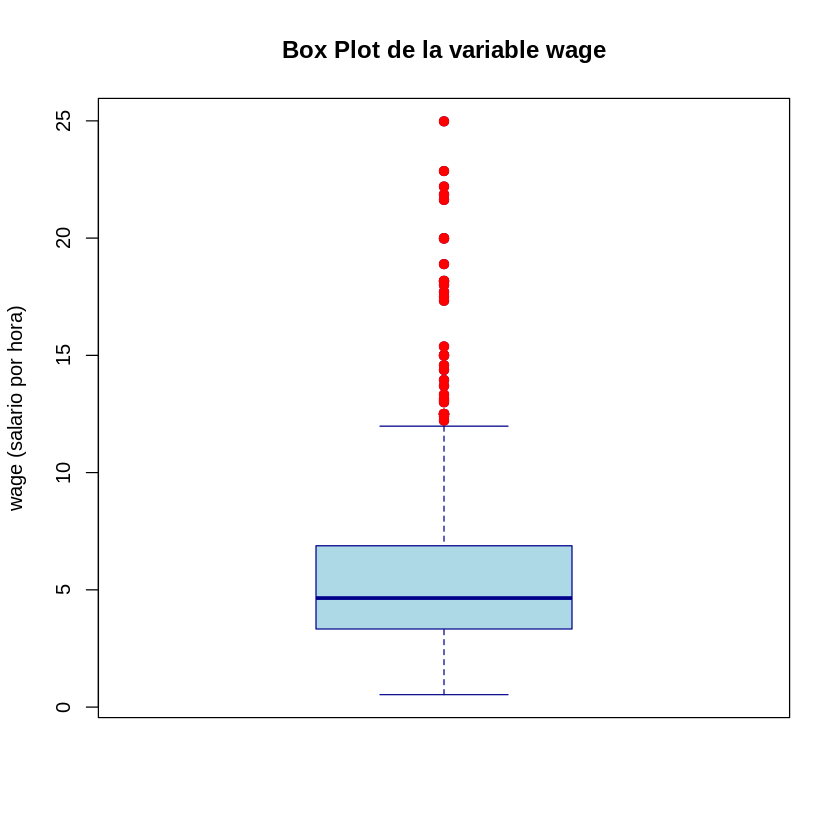
Línea en medio de la caja: \(Med\) (mediana).
-
Límite superior de la caja: \(q_3\) (tercer cuartil).
-
Límite inferior de la caja: \(q_1\) (primer cuartil).
-
notar que el largo de la caja representa el \(RIQ\) (rango intercuartilico).
-
Bigote superior: es el mínimo entre \(q_3+ 1.5RIQ\) y el máximo de los datos (\(X_n\)).
-
Bigote inferior: es el máximo entre \(q_1 - 1.5RIQ\) y el mínimo de los datos (\(X_1\)).
-
Puntos fuera de los bigotes: Todos los puntos que exceden los bigotes se grafican. Son puntos extremos (atípicos).
✍️ Practica · Tema 8
En un boxplot, ¿qué representa la caja?
✅ Láminas 9–10: la caja va de q₁ a q₃ y la línea interior es la mediana.
Dos cursos tienen promedio 5.0. En el A las notas van de 4.8 a 5.2; en el B, de 2.0 a 7.0. ¿Qué estadístico los distingue?
✅ Láminas 6–7: los estadísticos de dispersión miden cuán alejados están los datos de su centro.
🧪 Practica en R · Media, mediana y un atípico
Calcula los estadísticos de localización y dispersión de 15 sueldos con un valor atípico, y dibuja su histograma y su boxplot.
# 15 sueldos en miles de pesos; el último es un atípico (10 millones)
sueldos <- c(520, 610, 580, 700, 650, 590, 720, 680, 560, 630,
             600, 750, 640, 610, 10000)
c(media = mean(sueldos), mediana = median(sueldos))
c(desv_estandar = sd(sueldos), rango_intercuartil = IQR(sueldos))
quantile(sueldos)              # cuartiles: q1, mediana y q3

par(mfrow = c(1, 2))
hist(sueldos[-15], main = "Histograma (sin el atípico)", xlab = "miles de $")
boxplot(sueldos, main = "Boxplot: el atípico aparte")
par(mfrow = c(1, 1))
🎯 Reto: elimina el 10000 del vector. ¿Cuánto cambia la media? ¿Y la mediana?
Repaso de estadística inferencial
📄 Diapositivas: sem1/repaso_estadistica.tex · 34 láminas
TCL e intervalos de confianza para la media
¿Cuánto podemos confiar en un promedio calculado con una muestra?
Estadística Inferencial
-
Utiliza los datos muestrales para inferir sobre la población.
-
Requiere hacer supuesto sobre la población de interés. Uso de las teoría de probabilidades.
Intervalos de confianza (IC)
-
En lugar de ofrecer un valor único, se ofrece un rango de valores donde es más probable que el parámetro se encuentre.
-
Este rango de valores lo llamaremos Intervalo de confianza (IC).
-
Ventaja: da una idea de la precisión que se tiene al estimar.
-
Para construir un IC hay que decidir previamente el nivel de confianza que se quiere tener.
Teorema central del límite
-
La distribución muestral del promedio es la distribución de probabilidad de todos los posibles promedios de muestras de un determinado tamaño (\(n\)), seleccionadas desde una población.
-
Para una población con media \(\mu\) y varianza \(\sigma^2\) la distribución muestral de los promedios de todas las posibles muestras de tamaño n generadas desde la población serán, aproximadamente, normalmente distribuidas.
-
La media de la distribución muestral será igual a \(\mu\) y la varianza igual a \(\sigma^2/n\).
Supuestos TCL
-
Muestreo aleatorio: Las observaciones deben ser i.i.d. \((X_1, X_2, \ldots, X_n)\).
-
Tamaño muestral adecuado (regla de dedo):
\[ n \text{ debe ser } \begin{cases} \geq 30 & \text{para distribuciones simétricas (normal)} \\ \geq 50 & \text{para distribuciones asimétricas} \\ \geq 100 & \text{para distribuciones muy asimétricas} \end{cases} \] -
Varianza finita: \(\sigma^2 < \infty\)
-
Media finita: \(\mu < \infty\)
IC. ejemplo1
Una tienda quiere obtener una estimación de las ventas mensuales promedio de un cierto producto. Supongamos que las ventas de este producto son bastante estables a los largo del año. Se dispone de una m.a. \(X_1,...,X_{36}\) de datos de venta mensual y \(\bar{x}=200\). Obtener un IC de 95% para la media poblacional.
-
Como \(n=36>30\) aplica el TCL.
\[ \bar{X} \stackrel{aprox.}\sim N(\mu,\frac{\sigma^2}{n}) \] -
\(\mu\) es la media poblacional que desconocemos
-
\(\sigma^2\) es la varianza poblacional (supongamos que es conocida por el momento)
\[ \sigma^2=60^2 \]
Solución
-
\[ \frac{\bar{X}-\mu}{\frac{\sigma}{\sqrt{n}}}=\frac{\bar{X}-\mu}{\frac{60}{\sqrt{36}}}=\frac{\bar{X}-\mu}{10} \stackrel{aprox.}\sim N(0,1) \]
-
Intervalo de confianza de 95%
\[ P(a\leq \frac{\bar{X}-\mu}{\frac{\sigma}{\sqrt{n}}}\leq b)=0.95 \]
Solución (continuación)
El intervalos de confianza de 95% para \(\mu\) cuando \(\sigma\) es conocido está dado por:
-
Esto es así si \(n\geq 30\) o bien
-
si \(n<30\) pero la muestra es normal
Intervalo de confianza de 95%
El intervalo de confianza de 95% para \(\mu\) cuando \(\sigma\) es conocido está dado por:
-
Esto es así si \(n\geq 30\) o bien
-
si \(n<30\) pero la muestra es normal
Otros niveles de confianza
Si \(\alpha\) es un número entre 0 y 1. El intervalo de confianza de \(100(1-\alpha)\%\) para la media poblacional \(\mu\) cuando \(\sigma\) es conocido se obtiene de la siguiente forma:
-
Se identifica: \(z_{\frac{\alpha}{2}}\)
-
Finalmente el IC de \(100(1-\alpha)\%\) es:
\[ \color{red}{\bar{x} \pm z_{\frac{\alpha}{2}}\frac{\sigma}{\sqrt{n}}} \]
Suponga que se desea aumentar la confiabilidad y hacer un intervalo de 99%
-
\(1-\alpha=0.99,\) entonces \(\frac{\alpha}{2}=0.005\).:
\[ z_{0.005}=-2.57 \] -
\[ IC_{99\%}=(\bar{x}+z_{0.005}\frac{\sigma}{\sqrt{n}};\bar{x}-z_{0.005}\frac{\sigma}{\sqrt{n}}) \]
-
\[ IC_{99\%}=(200-(2.57)10;200+(2.57)10) \]
-
\[ \color{red}{IC_{99\%}=(174.3;225.7)} \]
Haz clic: Excel
Comparación de IC con distintos niveles de confianza.
Si aumento el nivel de confianza y el intervalo se hace mayor!!!
Intervalos de confianza: nivel de confianza y precisión
Si tomamos como estimador puntual \(\bar{X}\)
-
Con un 95% de confianza el verdadero valor del parámetro \(\mu\) no estará mas lejos de:
\[ E_{95}=(1.96)\frac{\sigma }{\sqrt{n}} \] -
Con un 99% de confianza el verdadero valor del parámetro \(\mu\) no estará mas lejos de:
\[ E_{99}=(2.58)\frac{\sigma }{\sqrt{n}} \] -
Llamaremos a \(E\) error absoluto de la estimación
Nivel de confianza y precisión.
-
Si para una misma muestra aumentamos el nivel de confianza (por ejemplo de 95% a 99%) lograremos una mejora en la confiabilidad... pero se pierde precisión (mayor error absoluto)
-
el error absoluto (\(E_{95}\)) del IC de 95%:
\[ {\color{blue}{E_{95}}}=(1.96)\frac{\sigma }{\sqrt{n}} \] -
el error absoluto (\(E_{99}\)) del IC de 99%:
\[ {\color{blue}{E_{99}}}=(2.58)\frac{\sigma }{\sqrt{n}} \] -
confiabilidad \((1-\alpha)\) \(\uparrow \Rightarrow\) precisión \(\downarrow\)
-
Intervalos de confianza: determinación del tamaño muestral
-
Antes de realizar un muestreo se puede definir el nivel de confianza y precisión (error absoluto) deseados y luego determinar el tamaño muestral (\(n\))
-
suponiendo \(\sigma\) conocido y eligiendo \(E\) (el error absoluto) y \(\alpha\):
\[ {\color{blue}{E}}=-z_{\frac{{\color{blue}{\alpha}}}{2}}\sigma/\sqrt{{\color{red}{n}}} \] -
luego, despejando \(n\):
\[ n=(z_{\frac{\alpha}{2}}\frac{\sigma}{E})^2 \] -
si el valor resultante no es entero se redondea hacia arriba.
✍️ Practica · Tema 9
¿Qué dice el Teorema Central del Límite?
✅ Láminas 3–4: X̄ ≈ N(μ, σ²/n) si n ≥ 30, o para cualquier n si la población es normal.
Con x̄ = 200, σ = 60 y n = 36, ¿cuál es el IC de 99% para μ?
✅ 200 ± 2.576 · 60/√36 = 200 ± 25.8. Pruébalo en la calculadora de intervalos.
🧪 Practica en R · El TCL y el 95%
Comprueba el TCL con una población muy asimétrica, reproduce el IC de la lámina 5 y verifica qué significa el 95%.
# TCL: la población es muy asimétrica, pero el promedio de 36 datos no
set.seed(36)
promedios <- replicate(5000, mean(rexp(36, rate = 1 / 200)))  # μ = σ = 200
hist(promedios, breaks = 40, main = "5 000 promedios de n = 36",
     xlab = "x barra")
c(media = mean(promedios), sd = sd(promedios), sd_teorica = 200 / 6)

# IC de 95% de la lámina 5: x barra = 200, σ = 60, n = 36
200 + c(-1, 1) * qnorm(0.975) * 60 / sqrt(36)

# ¿Qué significa el 95%? El intervalo atrapa a μ en ~95% de las muestras
cubre <- replicate(5000, {
  x <- rnorm(36, mean = 200, sd = 60)
  abs(mean(x) - 200) <= 1.96 * 60 / sqrt(36)
})
mean(cubre)
🎯 Reto: cambia 0.975 por 0.995 en el IC. ¿El intervalo de 99% es más ancho o más angosto?
Intervalos de confianza para proporciones
¿Cómo estimar un porcentaje, como la tasa de productos defectuosos?
Intervalos de confianza para las proporciones
-
Sea \(\bf{p}\) la proporción de éxitos en una población.
-
éxito: identifica a un individuo de una población con una determinada característica.
-
ejemplos:
-
proporción de fallas en una población de un determinado artefacto.
-
proporción de enfermos en una población.
-
proporción de aprobados en un curso
-
-
Recordemos que la v.a. :
\[ X\equiv \text{número de éxitos en una muestra de tamaño } n \]Distribuye \(Bin(n,p)\)
-
Además si \(n\geq 30\)
\[ X\stackrel{aprox.}\sim N(np,np(1-p)) \] -
Se pedirá adicionalmente que \(np>5\) y \(n(1-p)>5\)
-
Un buen estimador puntual para \(p\) es \(\hat{p}=\frac{X}{n}\) la fracción de éxitos en la muestra.
-
Ahora:
\[ \hat{p}\stackrel{aprox.}\sim N(p,\frac{p(1-p)}{n}) \]y
\[ \frac{\hat{p}-p}{\sqrt{\frac{p(1-p)}{n}}}\stackrel{aprox.}\sim N(0,1) \]
Entonces se puede emplear la distribución normal para armar un IC para las proporciones. En este caso:
Es decir:
El IC se construye como:
IC para las proporciones: ejemplo
Un fabricante asegura, a una compañía que le compra un producto en forma regular, que el porcentaje de productos defectuosos es 5%. La compañía decide comprobar la afirmación del fabricante seleccionando de su inventario 200 unidades del producto y probándolas. En este procedimiento se detectan 19 unidades defectuosas en la muestra. ¿Es coherente este resultado con la afirmación del proveedor? Utilice una confiabilidad de 95%.
IC para las proporciones. respuesta de ejemplo
Solución
El proveedor afirma que \(p\) es \(0.05\). Este valor no cae dentro del IC.
IC para las proporciones: determinación del tamaño muestral
-
Aquí también se puede determinar \(n\) fijando el nivel de confianza y el largo del intervalo.
-
se requiere una estimación inicial de \(p\), \(p^*\).
-
Para obtener \(p^*\) se puede extraer una muestra preliminar (más pequeña), o usar \(p^*=0.5\) (peor escenario).
-
En este caso el error absoluto es:
\[ E=-z_{\frac{\alpha}{2}}\sqrt{\frac{p^*(1-p^*)}{n}} \] -
luego, despejando \(n\):
\[ n=\frac{z_{\frac{\alpha}{2}}^2p^*(1-p^*)}{E^2} \]
IC para las proporciones
Un fabricante produce chips para computadores. Cada chip tiene una probabilidad \(p\) de tener una calidad aceptable. Para obtener un IC de 95% para \(p\) cuya longitud no exceda \(0.05\), se toma una muestra inicial de 30 chips. De estos 30 chips, 26 resultaron con una calidad aceptable. ¿Cuál es el tamaño muestral necesario para obtener un intervalo con las características requeridas?
✍️ Practica · Tema 10
Con 19 defectuosos en 200 unidades, el IC de 95% es (0.054; 0.136). El proveedor dice que p = 0.05. ¿Qué concluyes?
✅ Es la conclusión de la lámina 21.
Sin información previa sobre p, ¿qué p* conviene usar para calcular el tamaño muestral?
✅ Lámina 22: p* = 0.5 es el peor escenario.
🧪 Practica en R · Productos defectuosos
Reproduce el intervalo de la lámina 21 y calcula cuántas unidades harían falta para un error de ±3 puntos porcentuales.
# Lámina 20: 19 defectuosos en 200 unidades
x <- 19
n <- 200
p <- x / n
p + c(-1, 1) * qnorm(0.975) * sqrt(p * (1 - p) / n)  # (0.0543; 0.1356)

# Tamaño muestral para un error E = 0.03 con p* = 0.5 (peor escenario)
E <- 0.03
ceiling(qnorm(0.975)^2 * 0.5 * (1 - 0.5) / E^2)
🎯 Reto: usa p* = 0.095 en vez de 0.5 en el tamaño muestral. ¿Cuántas unidades necesitas ahora?
Intervalos para la diferencia de medias
¿Ganan distinto, en promedio, los egresados de dos carreras?
Intervalos de confianza diferencia de media de dos poblaciones
Se cree que el salario promedio de recién egresados de la carrera de ingeniería industrial es mayor que el salario promedio de recién egresados de arquitectura. Se obtuvieron muestras aleatorias de cada grupo de egresados:
-
\(X_1,....,X_{n_x}\): salarios de egresados de ing. industrial
-
\(Y_1,....,Y_{n_y}\): salarios de egresados de arquitectura
-
Se supone que las muestras son independientes entre si
Diferencia de media de dos poblaciones
Llamaremos:
-
\(\mu_x\): media poblacional de salarios de egresados de ing. industrial
-
\(\mu_y\): media poblacional de salarios de egresados de arquitectura
La idea es armar un IC para:
-
Si el cero cae dentro del intervalo, los datos no dan evidencia de diferencia entre las medias
-
Si el cero cae fuera del intervalo, los datos dan evidencia de diferencia entre las medias
Caso \(\sigma_x^2\) y \(\sigma_y^2\) conocidos, con \(n_x\) y \(n_y\) grandes
-
\(\bar{X} \stackrel{aprox.}\sim N(\mu_x,\frac{\sigma_x^2}{n_x})\)
-
\(\bar{Y} \stackrel{aprox.}\sim N(\mu_y,\frac{\sigma_y^2}{n_y})\)
-
\(\bar{X}-\bar{Y}\) también es aproximadamente normal
-
\(E(\bar{X}-\bar{Y})=E(\bar{X})-E(\bar{Y})=\mu_x-\mu_y\)
-
\(V(\bar{X}-\bar{Y})=V(\bar{X})+V(\bar{Y})=\frac{\sigma_x^2}{n_x}+\frac{\sigma_y^2}{n_y}\) (porque las muestras son independientes)
Por ello,
De aquí surge que:
\(P((\bar{X}-\bar{Y}) + z_{\frac{\alpha}{2}}\sqrt{\frac{\sigma_x^2}{n_x}+\frac{\sigma_y^2}{n_y}}\leq \mu_x-\mu_y\leq (\bar{X}-\bar{Y})-z_{\frac{\alpha}{2}}\sqrt{\frac{\sigma_x^2}{n_x}+\frac{\sigma_y^2}{n_y}})\) \(\simeq 1-\alpha\)
El IC de \((1-\alpha)100\%\) para la diferencia de medias \(\mu_x-\mu_y\) es:
Ejemplo
En el ejemplo de salarios. Supongamos que:
-
\(\bar{X}=\$800000\)
-
\(\bar{Y}=\$680000\)
-
\(n_x=144\)
-
\(n_y=121\)
-
\(\sigma_x=60000\)
-
\(\sigma_y=50000\)
Obtener un IC de 95% para la diferencia de medias.
Solución
El IC de 95% es:
Conclusión
Como el intervalo para \(\mu_x-\mu_y\) no contiene al cero, el resultado nos está dando evidencia de que las medias poblacionales son diferentes. Los salarios promedio de los egresados de ingeniería son más altos en promedio que los de arquitectura.
✍️ Practica · Tema 11
El IC de 95% para μₓ − μᵧ es (106 756; 133 244). ¿Qué significa que no contenga al cero?
✅ Es la conclusión de la lámina 34.
Si aumentas nₓ y nᵧ (y lo demás no cambia), el intervalo para μₓ − μᵧ…
✅ Más datos, menos incertidumbre: el error estándar disminuye.
🧪 Practica en R · Ingeniería contra arquitectura
Reproduce el intervalo de la lámina 33 para la diferencia de salarios promedio.
# Lámina 32: salarios de egresados de ingeniería (X) y arquitectura (Y)
xbar <- 800000; ybar <- 680000
nx   <- 144;    ny   <- 121
sx   <- 60000;  sy   <- 50000

ee <- sqrt(sx^2 / nx + sy^2 / ny)               # error estándar
(xbar - ybar) + c(-1, 1) * qnorm(0.975) * ee    # (106 756; 133 244)
🎯 Reto: ¿cuánto tendría que valer ybar para que el intervalo contuviera al cero? Pruébalo.
🧠 Ideas clave
- La econometría combina teoría económica y estadística para describir relaciones, estimar efectos causales y predecir.
- Correlación no es causalidad: un efecto causal compara situaciones ceteris paribus (helados, tiburones y temperatura).
- Los datos pueden ser experimentales u observacionales, y de corte transversal, series de tiempo o panel.
- Lo que hace representativa a una muestra es cómo se elige (aleatoriamente), no su tamaño: la sopa revuelta y el Literary Digest.
- Ayudantía: por el TCL, \(\bar{X}\) es aproximadamente \(N(\mu, \sigma^2/n)\); un IC de 95% atrapa a μ en el 95% de las muestras.
✅ Autoevaluación
Construiste un IC de 95% para μ y obtuviste (180.4 ; 219.6). ¿Cuál interpretación es correcta?
✅ μ es fijo: un intervalo ya calculado lo contiene o no. El 95% es una propiedad del procedimiento (revisa el simulador de cobertura). La tercera opción confunde la distribución de x̄ con la de las ventas individuales.
Si cuadruplicas el tamaño muestral n (manteniendo σ y la confianza), el error absoluto E…
✅ E = z·σ/√n, y √(4n) = 2√n. Para reducir el error a la mitad necesitas cuatro veces más datos.
En una muestra de 15 sueldos aparece uno de 10 millones. ¿Qué estadístico cambia más?
✅ La media usa el valor de cada dato, así que un atípico la arrastra; la mediana solo depende de la posición central. Pruébalo agregando un atípico en el simulador de estadística descriptiva.
📚 Para la próxima clase
- Wooldridge, capítulo 1 (La naturaleza de la econometría y los datos económicos) y apéndice C (repaso de estadística).
- Próxima clase: Regresión lineal simple.