Clase 4 · Regresión lineal múltiple
Contenido oficial de la semana
Esta página reproduce íntegros y en orden los materiales de la semana 4 (sem4/).
Cátedra del viernes: Parte 1 (Clase5.tex, 25 láminas). Ayudantía/taller: Parte 2
(calculo_matrices.tex, ejercicio de la inversa de \(X^\top X\)). Los bloques Interactivo, los casos
y las preguntas de autoevaluación son material adicional para estudiar.
Cómo estudiar esta clase
La clase está ordenada en 7 temas. Cada tema parte con una pregunta guía, sigue con las láminas y los simuladores, y termina con ✍️ preguntas de selección múltiple (cada alternativa incorrecta explica por qué no lo es) y un 🧪 ejercicio de R que puedes editar y ejecutar aquí mismo, sin instalar nada. Los 7 ejercicios de R en un solo archivo: 📥 clase4.R.
🎯 Objetivos de la sesión
Cátedra (viernes)
- Pasar del modelo simple al modelo de regresión lineal múltiple e interpretar cada \(\beta_j\) ceteris paribus.
- Plantear la estimación por MCO con \(k\) variables y escribir el modelo en notación matricial, \(y = X\beta + u\).
- Derivar \(\hat{\beta} = (X^\top X)^{-1} X^\top y\) y reconocer sus propiedades algebraicas.
- Distinguir entre \(R^2\) y \(R^2\) ajustado, y leer la salida de una regresión en R.
Ayudantía
- Calcular a mano \((X^\top X)^{-1}\) por cofactores y obtener \(\hat{\beta}\) con los datos del ejemplo.
🗓️ Agenda de la cátedra (viernes 18:40 – 21:25)
Haz clic en un tema para ir directo a él.
- 18:401Del modelo simple al múltipleParte 1 · láminas 1–3 · ✍️ 2 preguntas · 🧪 R
- 19:052MCO con k variablesParte 1 · láminas 4–5 · ✍️ 2 preguntas · 🧪 R
- 19:253Notación matricialParte 1 · láminas 6–9 · ✍️ 2 preguntas · 🧪 R
- 19:55☕ Receso
- 20:054La fórmula de MCO y sus propiedadesParte 1 · láminas 10–12 · ✍️ 2 preguntas · 🧪 R
- 20:355R² y R² ajustadoParte 1 · láminas 13–14 · ✍️ 2 preguntas · 🧪 R
- 20:556El ejemplo numérico y la salida en RParte 1 · láminas 15–25 · ✍️ 2 preguntas · 🧪 R
- 21:20✅ Ideas clave, autoevaluación y cierre
📘 Ayudantía · se trabaja otro día de la semana, no en la cátedra del viernes
Regresión lineal múltiple: estimación
📄 Diapositivas: sem4/Clase5.tex · 25 láminas
Del modelo simple al múltiple
¿Cómo medir el efecto de la educación dejando fija la inteligencia?
Modelo de Regresión Múltiple: Introducción
-
En las clases anteriores, vimos el modelo de regresión lineal simple:
\[ y = \beta_0 + \beta_1x + u \] -
Sin embargo, el supuesto de que \(E[u|x] = 0\) en dicho modelo es muy fuerte, ya que todas las variables no incluidas van al error.
-
Además, si nos interesa la predicción, es muy difícil predecir la variable \(y\) en base a una sola variable.
-
El modelo de regresión lineal múltiple (RLM) permite esto.
Modelo de Regresión Lineal Múltiple
-
A nivel poblacional, el modelo RLM se define como:
\[ y = \beta_0 + \beta_1x_1 + \beta_2x_2 + \ldots + \beta_kx_k + u \] -
Asumamos que \(E[u|x_1, x_2, \ldots, x_k] = 0\).
-
Interpretación de los parámetros \(\beta\):
-
Por ejemplo, si todas las variables excepto \(x_1\) permanecen constantes:
\[ \Delta E[y|x_1, x_2, \ldots, x_k] = \beta_1 \Delta x_1 \]\(\Rightarrow\) \(\beta_1 = \frac{\Delta E[y|x_1, x_2, \ldots, x_k]}{\Delta x_1}\)
-
Interpretación: Cuando \(x_1\) cambia en una unidad, el valor esperado de \(y\) cambia en \(\beta_1\) unidades, manteniendo todas las demás variables incluidas constantes.
Es como una derivada parcial!
Modelo de Regresión Múltiple: Estimación MCO
-
Al agregar más variables al modelo para poder estudiar el efecto de \(x\), ceteris paribus estas otras variables.
-
Por ejemplo, al estudiar el efecto de educación en salario, queremos dejar la inteligencia constante (IQ).
-
Al incluir esta variable en la regresión, podemos ver cuánto afecta un año más de educación en salario, dejando constante IQ.
-
De hecho, si agregamos la variable IQ, el coeficiente de educación que obtenemos se hace más pequeño.
MCO Simple: \(\hat{salario} = 0.09 + 0.54 \cdot educacion\)
MCO Múltiple: \(\hat{salario} = 0.065 + 0.37 \cdot educacion + 0.20 \cdot IQ\)
- Ahora vamos a ver cómo estimar los \(\hat{\beta}\) del modelo de regresión múltiple.
✍️ Practica · Tema 1
Con salario = 0.065 + 0.37·educación + 0.20·IQ, dos personas tienen el mismo IQ y una tiene un año más de educación. ¿Cuánto difiere su salario esperado?
✅ Lámina 2: cada β es una derivada parcial, con las demás variables incluidas constantes.
¿Por qué el coeficiente de educación baja de 0.54 a 0.37 al agregar el IQ?
✅ Es el sesgo por variable omitida de la Clase 3: β̃₁ = β₁ + β₂δ₁ con β₂ > 0 y δ₁ > 0.
🧪 Practica en R · Simple contra múltiple
Simula educación, IQ y salario. Compara el coeficiente de educación sin y con el IQ en la regresión.
set.seed(1)
n         <- 1000
IQ        <- rnorm(n, 100, 15)
educacion <- 12 + 0.1 * (IQ - 100) + rnorm(n, sd = 2)   # más IQ, más educación
salario   <- 1 + 0.37 * educacion + 0.05 * IQ + rnorm(n, sd = 2)

coef(lm(salario ~ educacion))        # simple: mezcla educación e IQ
coef(lm(salario ~ educacion + IQ))   # múltiple: educación con IQ fijo
🎯 Reto: cambia 0.1 * (IQ - 100) por 0 * (IQ - 100). ¿Siguen siendo distintos los dos coeficientes?
MCO con k variables
¿Qué cambia en MCO cuando hay más de una variable explicativa?
Modelo de Regresión Lineal Múltiple: Estimación
Dada una muestra de \(n\) individuos, tenemos la siguiente ecuación:
Igual que en el modelo RLS, los residuos vienen dados por:
MCO para el Modelo Lineal Múltiple
Es decir,
CPO:
...
Existen \(k + 1\) condiciones de primer orden para \(k + 1\) incógnitas.
✍️ Practica · Tema 2
Con k variables explicativas, ¿cuántas condiciones de primer orden tiene MCO?
✅ Lámina 5: una ecuación por cada β̂, incluido β̂₀.
Las condiciones de primer orden implican que los residuos…
✅ Son las mismas propiedades de la regresión simple, ahora para cada xⱼ.
🧪 Practica en R · Las k + 1 condiciones
Estima un modelo con tres variables y comprueba que se cumplen las cuatro condiciones de primer orden.
set.seed(2)
n  <- 200
x1 <- rnorm(n)
x2 <- rnorm(n)
x3 <- rnorm(n)
y  <- 1 + 2 * x1 - 1 * x2 + 0.5 * x3 + rnorm(n)

m <- lm(y ~ x1 + x2 + x3)
coef(m)
u <- resid(m)
# Las k + 1 = 4 condiciones de primer orden: Σû = 0 y Σ xj û = 0
round(c(sum(u), sum(x1 * u), sum(x2 * u), sum(x3 * u)), 10)
🎯 Reto: agrega una cuarta variable x4 <- rnorm(n) al modelo. ¿Cuántas condiciones hay que verificar ahora?
Notación matricial
¿Cómo escribir n ecuaciones en una sola línea?
Notación matricial modelo poblacional
-
El modelo de regresión lineal múltiple cada individuo \(i\) es:
\[ y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + \dots + \beta_k x_{ik} + u_i \quad \forall i = 1, \dots, n \] -
Matricialmente, lo podemos expresar:
\[ y_i = \mathbf{x}_i^\top \mathbf{\beta} + u_i \quad \forall i = 1, \dots, n \]con
\[ \mathbf{x}_i = \begin{pmatrix} 1 \\ x_{i1} \\ \vdots \\ x_{ik} \end{pmatrix}, \quad \mathbf{\beta} = \begin{pmatrix} \beta_0 \\ \beta_1 \\ \vdots \\ \beta_k \end{pmatrix} \] -
Noten que son \(n\) ecuaciones (una para cada individuo).
Notación
-
\[ y = X\beta + u \]
con
\[ y = \begin{pmatrix} y_1 \\ \vdots \\ y_n \end{pmatrix}, \quad X = \begin{pmatrix} \mathbf{x}_1^\top \\ \vdots \\ \mathbf{x}_n^\top \end{pmatrix} = \begin{pmatrix} 1 & x_{11} & \dots & x_{1k} \\ \vdots & \vdots & \ddots & \vdots \\ 1 & x_{n1} & \dots & x_{nk} \end{pmatrix}, \quad u = \begin{pmatrix} u_1 \\ \vdots \\ u_n \end{pmatrix} \]donde \(u\) y \(y\) son vectores de \(n \times 1\) y \(X\) es una matriz de \(n \times (k + 1)\).
Ejemplo: \(n=5\), dos variables: \(x_1\), \(x_2\)
Re-escribiendo:
Mínimos Cuadrados Ordinarios (MRL Múltiple)
-
Como antes, podemos definir:
-
\(\hat{\beta}\): estimadores de los \(\beta\) dimensión, \((k+1) \times 1\)
-
\(\hat{y} = X \hat{\beta}\): Valores predichos de \(y\), dimensión \(n \times 1\)
-
Por lo tanto, los residuos en forma matricial:
\[ \hat{u} = y - \hat{y} = y - X \hat{\beta} \]
-
✍️ Practica · Tema 3
En y = Xβ + u, con n = 5 y dos variables explicativas, ¿qué dimensión tiene β?
✅ β tiene un elemento por parámetro: k + 1 = 3.
¿Para qué sirve la columna de unos en X?
✅ Láminas 7–8: la primera columna de X es de unos.
🧪 Practica en R · Arma X con los datos de la lámina
Construye la matriz X del ejemplo de la lámina 8 y calcula XᵀX y Xᵀy. Compara Xᵀy con la lámina 22.
# Datos de la lámina 8 (y del ejercicio de la ayudantía)
experiencia <- c(12, 18, 14, 12, 11)
educacion   <- c(93, 119, 108, 96, 74)
salario     <- c(769, 808, 825, 650, 562)

X <- cbind(unos = 1, experiencia, educacion)   # n × (k + 1)
y <- salario
X
dim(X)
t(X) %*% X        # XᵀX: (k + 1) × (k + 1)
t(X) %*% y        # Xᵀy
🎯 Reto: agrega una tercera variable, por ejemplo edad <- c(30, 41, 35, 29, 26), a X. ¿Qué dimensión tiene ahora XᵀX?
La fórmula de MCO y sus propiedades
¿De dónde sale β̂ = (XᵀX)⁻¹Xᵀy?
Recordar
-
Derivadas
Si \(a\) y \(\beta\) son vectores y \(A\) una matriz simétrica, entonces:
-
\(\frac{da^\top \beta}{d\beta} = a\)
-
\(\frac{d\beta^\top A\beta}{d\beta} = 2A\beta\)
-
-
Propiedades de la traspuesta
Sean \(D\) y \(E\) matrices: \((DE)^\top = E^\top D^\top\)
-
Potencias
\(\sum_{i} (s_i)^2 = s^\top s\)
Mínimos Cuadrados Ordinarios (MRL Múltiple)
-
La suma de los residuos al cuadrado es:
\[ \hat{u}^\top \hat{u} = (y - X \hat{\beta})^\top (y - X \hat{\beta}) \]\[ = y^\top y - \hat{\beta}^\top X^\top y - y^\top X \hat{\beta} + \hat{\beta}^\top X^\top X \hat{\beta} \]\[ = y^\top y - 2 y^\top X \hat{\beta} + \hat{\beta}^\top X^\top X \hat{\beta} \] -
Entonces, condiciones de primer orden:
\[ \frac{\partial \hat{u}^\top \hat{u}}{\partial \hat{\beta}} = 0 \quad \Rightarrow \quad -2X^\top y + 2X^\top X \hat{\beta} = 0 \quad \Rightarrow \quad \hat{\beta} = (X^\top X)^{-1} X^\top y \] -
Note que precisamos suponer que \(X\) tiene rango \((k+1)\) completo \(\Rightarrow X^\top X\) es invertible.
-
Las \(k + 1\) ecuaciones \(X^\top y = X^\top X \hat{\beta}\) son llamadas ecuaciones normales para MCO.
-
Condición de segundo grado: \(\frac{d^2 \hat{u}^\top \hat{u}}{d \hat{\beta} d \hat{\beta}} = 2X^\top X\) positiva definida.
Propiedades algebraicas
-
Al igual que el caso de regresión simple, las propiedades algebraicas se derivan de las CPO.
-
Propiedades 1 y 2: \(X^\top \hat{u} = 0\):
\[ \sum_{i} \hat{u}_i = 0 \quad (\text{propiedad 1}) \]\[ \sum_{i} x_{i1} \hat{u}_i = 0 \quad (\text{propiedad 2}) \]\[ \sum_{i} x_{i2} \hat{u}_i = 0 \quad (\text{propiedad 2}) \]\[ \dots \]\[ \sum_{i} x_{ik} \hat{u}_i = 0 \quad (\text{propiedad 2}) \] -
Propiedad 3: La media de la variable observada \(y\) es igual a la media de la variable predicha \(\hat{y}\):
\[ \bar{y} = \bar{\hat{y}} \] -
Propiedad 4: El punto \((\bar{x}_1, \bar{x}_2, \dots, \bar{x}_k, \bar{y})\) pasa por la curva de regresión.
✍️ Practica · Tema 4
Si X es n × (k + 1), ¿qué dimensión tiene XᵀX?
✅ XᵀX es cuadrada, del tamaño del número de parámetros.
La condición Xᵀû = 0 significa que…
✅ Lámina 12: propiedades algebraicas de MCO en forma matricial.
🧪 Practica en R · La fórmula en R
Calcula β̂ = (XᵀX)⁻¹Xᵀy con matrices, compáralo con lm() y verifica que Xᵀû = 0.
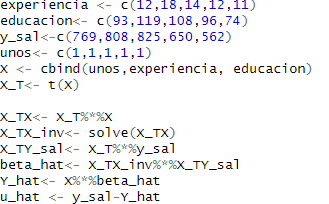
experiencia <- c(12, 18, 14, 12, 11)
educacion   <- c(93, 119, 108, 96, 74)
salario     <- c(769, 808, 825, 650, 562)
X <- cbind(1, experiencia, educacion)
y <- salario

beta <- solve(t(X) %*% X) %*% t(X) %*% y     # (XᵀX)⁻¹ Xᵀy
beta
coef(lm(salario ~ experiencia + educacion))  # lo mismo

u_hat <- y - X %*% beta
round(t(X) %*% u_hat, 8)                     # Xᵀû = 0
🎯 Reto: duplica una columna: usa X <- cbind(1, experiencia, experiencia). ¿Qué error da solve() y por qué?
R² y R² ajustado
¿Mejora el modelo cada vez que agregamos una variable?
Bondad de Ajuste: \(R^2\)
El \(R^2\) nos dice que la proporción de la varianza muestral de \(y\) es explicada por nuestra regresión MCO. Recordando las definiciones:
-
Suma de cuadrados explicada: \(SSE = \sum_{i=1}^{n} (\hat{y}_i - \bar{y})^2\)
-
Suma de cuadrados residual: \(SSR = \sum_{i=1}^{n} \hat{u}_i^2\)
-
Suma de cuadrados total: \(SST = \sum_{i=1}^{n} (y_i - \bar{y})^2\)
La fórmula para el \(R^2\) es igual que en el caso de la regresión simple:
Bondad de Ajuste: \(R^2\) ajustado
-
\(R^2\) crece (o queda igual) a medida que se agregan más variables al modelo. Esto ocurre incluso si la variable agregada no es relevante en el modelo poblacional.
-
Necesitamos una medida que penalice agregar variables irrelevantes.
-
Se define el \(R^2\) ajustado como:
\[ \overline{R^2} = 1 - \frac{n - 1}{n - k - 1} \frac{SSR}{SST} \]
✍️ Practica · Tema 5
Con n = 5, k = 2 y R² = 0.7751, ¿cuánto vale el R² ajustado?
✅ 1 − (4/2)·(1 − 0.7751) = 0.5501, como en la salida de R de la lámina 25.
¿Puede el R² ajustado ser negativo?
✅ La penalización (n − 1)/(n − k − 1) puede superar lo que explica el modelo.
🧪 Practica en R · La trampa del R²
Agrega 10 variables sin ninguna relación con y y compara el R² con el R² ajustado.
set.seed(5)
n <- 30
x <- rnorm(n)
y <- 1 + 2 * x + rnorm(n, sd = 2)
r2 <- function(m) c(R2 = summary(m)$r.squared,
                    R2_ajustado = summary(m)$adj.r.squared)

basura <- matrix(rnorm(n * 10), n, 10)  # 10 variables sin relación con y
rbind(solo_x     = r2(lm(y ~ x)),
      x_y_basura = r2(lm(y ~ x + basura)))
🎯 Reto: agrega 20 variables basura (cambia los dos 10 por 20). ¿Qué pasa con el R² ajustado?
El ejemplo numérico y la salida en R
¿Cómo se ven todos estos cálculos en una salida de R?
Ejemplo: obtener \(\hat{\beta} = (X^\top X)^{-1}X^\top y\)
Lámina progresiva · recórrela paso a paso, como en la presentación
Modelo: \(y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + u_i\), \(n=5\).
Base de datos:
| Individuos | unos | \(x_1\) (experiencia) | \(x_2\) (educación) | \(y\) (salario) |
|---|---|---|---|---|
| Juan | 1 | 12 | 93 | 769 |
| Pedro | 1 | 18 | 119 | 808 |
| Sofia | 1 | 14 | 108 | 825 |
| Caro | 1 | 12 | 96 | 650 |
| Alex | 1 | 11 | 74 | 562 |
Modelo: \(y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + u_i\), \(n=5\).
Base de datos:
| Individuos | unos | \(x_1\) (experiencia) | \(x_2\) (educación) | \(y\) (salario) |
|---|---|---|---|---|
| Juan | 1 | 12 | 93 | 769 |
| Pedro | 1 | 18 | 119 | 808 |
| Sofia | 1 | 14 | 108 | 825 |
| Caro | 1 | 12 | 96 | 650 |
| Alex | 1 | 11 | 74 | 562 |
Modelo: \(y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + u_i\), \(n=5\).
Base de datos:
| Individuos | unos | \(x_1\) (experiencia) | \(x_2\) (educación) | \(y\) (salario) |
|---|---|---|---|---|
| Juan | 1 | 12 | 93 | 769 |
| Pedro | 1 | 18 | 119 | 808 |
| Sofia | 1 | 14 | 108 | 825 |
| Caro | 1 | 12 | 96 | 650 |
| Alex | 1 | 11 | 74 | 562 |
Entonces tenemos: \((X^{\top}X)^{-1} = \begin{bmatrix} 8.80 & 0.19 & -0.11 \\ 0.19 & 0.17 & -0.02 \\ -0.11 & -0.02 & 0.00 \\ \end{bmatrix}\)
\(X^{\top}y = \begin{bmatrix} 3614 \\ 49304 \\ 360757 \\ \end{bmatrix}\)
Entonces tenemos: \((X^{\top}X)^{-1} = \begin{bmatrix} 8.80 & 0.19 & -0.11 \\ 0.19 & 0.17 & -0.02 \\ -0.11 & -0.02 & 0.00 \\ \end{bmatrix}\)
\(X^{\top}y = \begin{bmatrix} 3614 \\ 49304 \\ 360757 \\ \end{bmatrix}\)
Multiplicando obtenemos los estimadores: \(\hat{\beta} = (X^{\top}X)^{-1}X^{\top}y=
\begin{bmatrix}
\hat{\beta}_0 \\
\hat{\beta}_1 \\
\hat{\beta}_2 \\
\end{bmatrix}=
\begin{bmatrix}
140.59 \\
-16.79 \\
8.24 \\
\end{bmatrix}\)
Entonces tenemos: \((X^{\top}X)^{-1} = \begin{bmatrix} 8.80 & 0.19 & -0.11 \\ 0.19 & 0.17 & -0.02 \\ -0.11 & -0.02 & 0.00 \\ \end{bmatrix}\)
\(X^{\top}y = \begin{bmatrix} 3614 \\ 49304 \\ 360757 \\ \end{bmatrix}\)
Multiplicando obtenemos los estimadores: \(\hat{\beta} = (X^{\top}X)^{-1}X^{\top}y=
\begin{bmatrix}
\hat{\beta}_0 \\
\hat{\beta}_1 \\
\hat{\beta}_2 \\
\end{bmatrix}=
\begin{bmatrix}
140.59 \\
-16.79 \\
8.24 \\
\end{bmatrix}\)
Si quisieramos la matrix de prediccion de y, simplemente calculamos:
En general
En R
Regresión
✍️ Practica · Tema 6
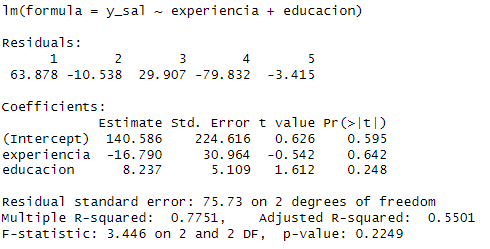
En la lámina 25, el coeficiente de experiencia es −16.79 con p-valor 0.642. ¿Qué indica?
✅ Con n = 5 y 3 parámetros quedan 2 grados de libertad: los errores estándar son enormes.
Una vez calculado β̂, ¿cómo se obtienen las predicciones ŷ?
✅ Lámina 22.
🧪 Practica en R · La salida de la lámina 25
Reproduce la regresión de la lámina 25 con los 5 datos y calcula el R² ajustado a mano.
datos <- data.frame(
  experiencia = c(12, 18, 14, 12, 11),
  educacion   = c(93, 119, 108, 96, 74),
  y_sal       = c(769, 808, 825, 650, 562)
)
m <- lm(y_sal ~ experiencia + educacion, data = datos)
summary(m)                 # compárala con la lámina 25

# R² ajustado a mano, con n = 5 y k = 2
R2 <- summary(m)$r.squared
1 - (5 - 1) / (5 - 2 - 1) * (1 - R2)
fitted(m)                  # ŷ = X beta gorro
🎯 Reto: agrega un sexto individuo a los datos (por ejemplo, 15, 100 y 700). ¿Cómo cambian los errores estándar?
Ejercicio: la inversa de XᵀX por cofactores
📄 Documento: sem4/calculo_matrices.tex · 7 secciones
Material de ayudantía/taller
Este ejercicio no se ve en la cátedra del viernes: se trabaja en la ayudantía/taller de la semana. Mantiene el formato numérico del documento original (punto para los miles, coma decimal).
La inversa de XᵀX por cofactores
¿Cómo se invierte a mano una matriz de 3 × 3?
Modelo y datos
Modelo de regresión lineal múltiple con \(n=5\) individuos:
donde \(x_{1}=\) experiencia (años) y \(x_{2}=\) educación (años).
| Individuo | unos | \(x_1\) (experiencia) | \(x_2\) (educación) | \(y\) (salario) |
|---|---|---|---|---|
| Juan | 1 | 12 | 93 | 769 |
| Pedro | 1 | 18 | 119 | 808 |
| Sofía | 1 | 14 | 108 | 825 |
| Caro | 1 | 12 | 96 | 650 |
| Alex | 1 | 11 | 74 | 562 |
Matrices del modelo:
Multiplicando \(X^\top X\) (cada entrada es la suma de productos correspondiente: \(n\), \(\sum x_1\), \(\sum x_2\), \(\sum x_1^2\), \(\sum x_1 x_2\), \(\sum x_2^2\)):
El objetivo de este documento es obtener \(A^{-1}=(X^\top X)^{-1}\) paso a paso, usando el método de cofactores:
donde \(C\) es la matriz de cofactores de \(A\).
Paso 1: Matriz de menores
El menor \(M_{ij}\) es el determinante de la submatriz \(2\times 2\) que resulta de eliminar la fila \(i\) y la columna \(j\) de \(A\).
Por lo tanto, la matriz de menores es:
(Nota: como \(A=X^\top X\) es simétrica, se cumple \(M_{12}=M_{21}\) y \(M_{13}=M_{31}\), \(M_{23}=M_{32}\), lo cual sirve como chequeo intermedio.)
Paso 2: Matriz de cofactores
Cada cofactor se obtiene aplicando el patrón de signos (tablero de ajedrez) a los menores:
Paso 3: Matriz adjunta (adjunta = transpuesta de cofactores)
Como \(A\) es simétrica, \(C\) también resulta simétrica, así que \(\operatorname{adj}(A)=C\) en este caso particular (esto no ocurre en general; solo porque \(A=X^\top X\) es simétrica).
Paso 4: Determinante de \(A\)
El determinante se calcula expandiendo por cofactores a lo largo de la primera fila:
Paso 5: Matriz inversa
Dividiendo cada entrada por \(34.276\) se obtiene, en decimales:
Cálculo de \(\hat\beta=(X^\top X)^{-1}X^\top y\)
Como la base de datos ya incluye la variable \(y\) (salario), es posible completar el ejercicio calculando el vector \(X^\top y\) y luego el estimador OLS. Con \(y=(769,\,808,\,825,\,650,\,562)^\top\):
Luego:
Es decir, \(\hat\beta_0\approx 140,586\), \(\hat\beta_1\approx -16,790\) y \(\hat\beta_2\approx 8,237\).
✍️ Practica · Tema 7
¿Cuándo existe la inversa de A = XᵀX?
✅ A⁻¹ = adj(A)/det(A): con det(A) = 0 habría que dividir por cero.
La matriz adjunta es…
✅ Paso 3 del documento.
🧪 Practica en R · Cofactores en R
Repite los 5 pasos del documento: determinante, cofactores, adjunta e inversa, y compara con solve().
experiencia <- c(12, 18, 14, 12, 11)
educacion   <- c(93, 119, 108, 96, 74)
X <- cbind(1, experiencia, educacion)
A <- t(X) %*% X
det(A)

# Cofactor (i, j) = (−1)^(i + j) · determinante del menor sin fila i ni columna j
cof <- matrix(0, 3, 3)
for (i in 1:3) for (j in 1:3) cof[i, j] <- (-1)^(i + j) * det(A[-i, -j])
adjunta <- t(cof)
inversa <- adjunta / det(A)

round(inversa, 4)
round(solve(A), 4)          # la inversa que calcula R: igual
round(A %*% inversa, 10)    # la identidad
🎯 Reto: calcula β̂ con tu inversa: inversa %*% t(X) %*% c(769, 808, 825, 650, 562).
🧠 Ideas clave
- En la regresión múltiple cada \(\beta_j\) es un efecto ceteris paribus: la pendiente del plano en la dirección de \(x_j\).
- Controlar por una variable cambia el coeficiente de interés (0.54 → 0.37 al agregar IQ), como predice la fórmula de variable omitida.
- En notación matricial \(y = X\beta + u\), con \(X\) de dimensión \(n \times (k+1)\), y \(\hat{\beta} = (X^\top X)^{-1} X^\top y\) exige rango completo.
- El \(R^2\) nunca baja al agregar variables; el \(R^2\) ajustado penaliza cada variable adicional.
✅ Autoevaluación
En salario = 0.065 + 0.37·educación + 0.20·IQ, ¿qué significa 0.37?
✅ En la regresión múltiple cada coeficiente es un efecto ceteris paribus: la pendiente del plano en la dirección de esa variable, con las demás incluidas fijas.
Con n = 100 observaciones y k = 4 variables explicativas, ¿qué dimensión tiene la matriz X?
✅ X tiene una fila por observación y una columna por parámetro: la columna de unos más las 4 variables, es decir n × (k + 1) = 100 × 5.
¿Por qué se exige que X tenga rango completo (k + 1)?
✅ Si una columna es combinación lineal de otras (por ejemplo, dos variables idénticas), XᵀX no se puede invertir y MCO no tiene solución única. Pruébalo en la calculadora.
Agregas al modelo una variable que no tiene ninguna relación con y. ¿Qué pasa?
✅ El R² nunca baja al agregar variables; el R² ajustado penaliza con (n − 1)/(n − k − 1). Es la trampa del R² que viste en el juego.
📚 Para la próxima clase
- Wooldridge, capítulo 3, secciones 3.1–3.2 (Análisis de regresión múltiple: estimación).
- 🛠️ Esta semana es el Taller 1: repasa el ejercicio de la Parte 2 y verifica tus cálculos con la calculadora matricial.
- Próxima clase: Interpretación de la regresión múltiple.