Clase 2 · Regresión lineal simple
Contenido oficial de la semana
Esta página reproduce íntegras y en orden las diapositivas de la semana 2
(sem2/clase2.tex, 34 láminas), todas de la cátedra del viernes. Los bloques
Interactivo, los casos y las preguntas de autoevaluación son material adicional para estudiar.
Cómo estudiar esta clase
La clase está ordenada en 7 temas. Cada tema parte con una pregunta guía, sigue con las láminas y los simuladores, y termina con ✍️ preguntas de selección múltiple (cada alternativa incorrecta explica por qué no lo es) y un 🧪 ejercicio de R que puedes editar y ejecutar aquí mismo, sin instalar nada. Los 7 ejercicios de R en un solo archivo: 📥 clase2.R.
🎯 Objetivos de la sesión
- Plantear el modelo de regresión lineal simple (RLS) e interpretar sus parámetros.
- Entender el supuesto clave \(E[u \mid x] = 0\) y la función de regresión poblacional.
- Derivar e interpretar los estimadores de Mínimos Cuadrados Ordinarios (MCO).
- Descomponer la variabilidad de \(y\) (\(SST = SSE + SSR\)) y medir la bondad de ajuste con el \(R^2\).
- Conocer los supuestos RLS 1–5 y las propiedades de insesgamiento y varianza de MCO.
🗓️ Agenda de la cátedra (viernes 18:40 – 21:25)
Haz clic en un tema para ir directo a él.
- 18:401El modelo de regresión lineal simpleláminas 1–4 · ✍️ 2 preguntas · 🧪 R
- 19:052El supuesto clave y la regresión poblacionalláminas 5–11 · ✍️ 2 preguntas · 🧪 R
- 19:303Estimar por mínimos cuadrados ordinariosláminas 12–15 · ✍️ 2 preguntas · 🧪 R
- 19:55☕ Receso
- 20:054La regresión muestral y sus propiedadesláminas 16–20 · ✍️ 2 preguntas · 🧪 R
- 20:305Método de momentosláminas 21–23 · ✍️ 2 preguntas · 🧪 R
- 20:456Bondad de ajuste y unidades de medidaláminas 24–26 · ✍️ 2 preguntas · 🧪 R
- 21:057Supuestos, insesgamiento y varianzaláminas 27–34 · ✍️ 2 preguntas · 🧪 R
- 21:25✅ Ideas clave, autoevaluación y cierre
Regresión lineal simple
📄 Diapositivas: sem2/clase2.tex · 34 láminas
El modelo de regresión lineal simple
¿Cómo escribir que el salario depende de la educación… y de todo lo demás?
Modelo de regresión lineal simple
-
Queremos estudiar la relación entre dos variables x e y en la población.
-
Explicar y en terminos de x o como cambia y cuando cambia x.
-
Modelo de regresión lineal simple (RLS):
\[ y = \beta_0 + \beta_1 x + u \] -
\(\beta_0\), \(\beta_1\) son parámetros poblacionales.
-
u: término de error o perturbación, factores no-observables que afectan a y.
-
El coeficiente \(\beta_0\), permite suponer que E(u) = 0.
-
\(\beta_1\) captura como cambia y cuando cambia x.
Terminología:
-
y: variable dependiente, variable explicada, variable de respuesta, variable predicha o el regresando.
-
x: variable independiente, variable explicativa, variable de control, variable predictora o el regresor.
-
\(\beta_1\): es el parámetro de la pendiente en la relación entre y y x, cuando todos los demás factores en u permanecen constantes, este parámetro es de interés primordial en la economía aplicada.
-
\(\beta_0\): es el parámetro del intercepto, algunas veces llamado término constante.
Termino de error
-
La variable u, llamada término de error, o perturbación en la relación, representa factores distintos a x que afectan a y.
-
Un análisis de regresión simple en realidad trata a todos los factores que afectan a y, y que son distintos a x como factores no observados.
-
Es útil considerar a u como abreviación de "unobserved".
Ejemplo
-
Por ejemplo:
\[ \text{salario} = \beta_0 + \beta_1 \text{educación} + u \] -
Noten que si todos los demás factores son constantes (\(\Delta u = 0\)), entonces:
\[ \Delta \text{salario} = \beta_1 \Delta \text{educación} \] -
\(\beta_1\) es el parámetro de la pendiente en la relación entre \(y\) y \(x\), cuando los factores no observables son constantes. PERO, en general, ¿son constantes?
✍️ Practica · Tema 1
En salario = β₀ + β₁·educación + u, ¿qué es u?
✅ Láminas 3–4: el término de error reúne todo lo que afecta a y además de x.
En y = β₀ + β₁x + u, ¿cómo se llama y?
✅ Lámina 2: terminología del modelo de regresión simple.
🧪 Practica en R · La función de regresión poblacional
Simula 100 personas con un modelo conocido y dibuja la FRP. Cada punto se aleja de la recta en su propio u.
set.seed(1)
n <- 100
educacion <- sample(8:20, n, replace = TRUE)
u <- rnorm(n, sd = 3)                    # todo lo demás que afecta el salario
salario <- 0.1 + 0.55 * educacion + u    # beta0 = 0.1, beta1 = 0.55

plot(educacion, salario, pch = 19, col = "steelblue",
     main = "Cada punto se aleja de la recta en su u")
abline(a = 0.1, b = 0.55, lwd = 2)       # la FRP: E[salario | educacion]
🎯 Reto: cambia sd = 3 por sd = 0.5. ¿Qué pasa con la nube de puntos?
El supuesto clave y la regresión poblacional
¿Qué tiene que cumplir u para que β₁ mida el efecto de x?
Modelo de regresión lineal simple
-
Modelo de regresión lineal simple:
\[ y = \beta_0 + \beta_1 x + u \tag{2} \] -
PERO, en general, ¿son constantes?
-
Difícil decir que \(u\) es constante cuando no lo observamos.
-
El supuesto clave para estimar \(\beta_1\) (cómo \(x\) afecta a \(y\)) es que:
\[ E[u|x] = 0 \]\(\rightarrow\) el valor promedio de \(u\) es igual para cualquier valor de \(x\). Además, es igual a cero, implicando que \(x\) no está correlacionada con los factores no observables.
-
Sin esa restricción, no es posible estimar el efecto ceteris paribus \(\beta_1\).
Supuestos
-
Linealidad en los parámetros: la función que relaciona \(y\) con \(x\) es lineal.
-
Media condicional cero:
\[ E[u|x] = E[u] = 0 \]\(\rightarrow\) El valor esperado de los factores inobservables no depende de los valores de \(x\), y dicho promedio es igual a 0, u es media independiente de x.
Ejemplo
¿Qué hay en u? ¿Como se relaciona con x?
Regresión Poblacional
-
Si se cumplen los supuestos anteriores (linealidad y \(E[u|x] = 0\)):
-
Entonces:
\[ y = \beta_0 + \beta_1x + u \]\[ E[y|x] = \beta_0 + \beta_1E[x|x] + E[u|x] \]\[ E[y|x] = \beta_0 + \beta_1x \] -
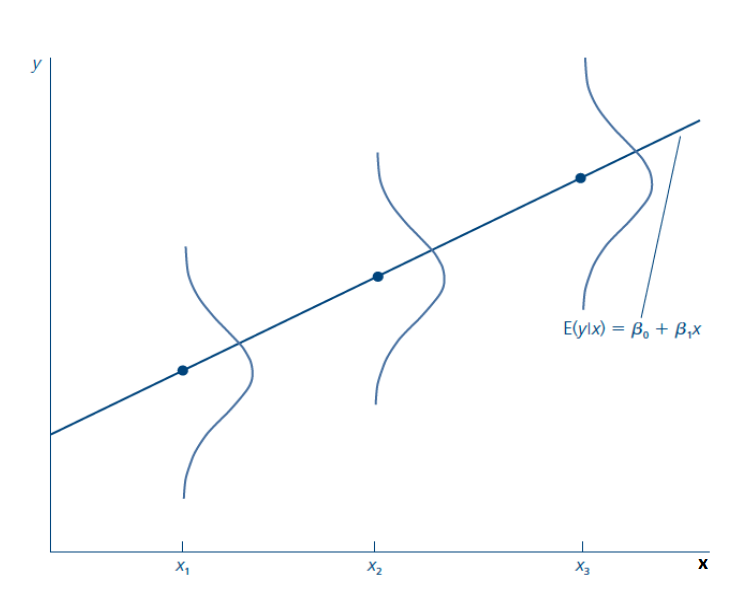
Por lo tanto, el MRS aproxima la esperanza condicional de y.
-
A la línea \(E[y|x]\) se le llama Función de Regresión Poblacional (FRP).
Esperanza condicional
La función de esperanza condicional es la esperanza de una variable \(Y_i\) (o su media poblacional) cuando \(X_i\) está fijo.
| Individuo | Años educ. | Ingreso |
|---|---|---|
| María | 5 | 120 |
| Juan | 5 | 100 |
| Pedro | 4 | 80 |
| Catalina | 2 | 50 |
FEC para cada nivel de educación:
\(E[Y_i|X_i = 5] = 110\)
\(E[Y_i|X_i = 4] = 80\)
\(E[Y_i|X_i = 2] = 50\)
\(E[Y_i] = 87.5\)
Regresión Poblacional: FRP
Interpretación
Noten que:
\(\rightarrow\) es la pendiente de la Función de la FRP, cuando \(x\) aumenta en una unidad, el valor esperado de \(y\) cambia en \(\beta_1\) unidades.
\(\rightarrow\) es el intercepto de la FRP, el valor medio de \(y\) cuando \(x\) es igual a cero.
✍️ Practica · Tema 2
Si u incluye la habilidad, y las personas más hábiles estudian más, ¿qué supuesto falla?
✅ Láminas 6–7: si la habilidad está en u y se relaciona con la educación, E[u | x] ≠ 0.
La función de regresión poblacional E[y | x] = β₀ + β₁x describe…
✅ Láminas 8–10: la FRP es una esperanza condicional.
🧪 Practica en R · Cuando E[u | x] no es cero
Compara dos mundos: uno en que la habilidad no se relaciona con la educación y otro en que los más hábiles estudian más. El verdadero β₁ es 0.5 en ambos.
set.seed(2)
n <- 5000
habilidad <- rnorm(n)                     # está en u: no la observamos

# Caso 1: la educación no depende de la habilidad -> E[u | x] = 0
educ1 <- rnorm(n, 12, 2)
sal1  <- 1 + 0.5 * educ1 + 2 * habilidad + rnorm(n)

# Caso 2: los más hábiles estudian más -> E[u | x] cambia con x
educ2 <- 12 + 1.5 * habilidad + rnorm(n)
sal2  <- 1 + 0.5 * educ2 + 2 * habilidad + rnorm(n)

c(caso1 = unname(coef(lm(sal1 ~ educ1))[2]),
  caso2 = unname(coef(lm(sal2 ~ educ2))[2]))   # verdadero: 0.5

# Promedio de u por tramos de educación en el caso 2: ¡no es cero!
tapply(2 * habilidad, cut(educ2, 4), mean)
🎯 Reto: cambia 1.5 * habilidad por -1.5 * habilidad. ¿Hacia dónde se mueve la estimación del caso 2?
Estimar por mínimos cuadrados ordinarios
De todas las rectas posibles, ¿cuál elegimos?
Estimación
-
Objetivo: estimar los parámetros poblacionales a partir de una muestra.
-
Sea el modelo poblacional: \(y = \beta_0 + \beta_1x + u\)
-
Entonces, para cada \(i = 1, \ldots, n\) de una muestra podemos escribir:
\[ y_i = \beta_0 + \beta_1x_i + u_i \]donde \(u_i\) es el término de error para la observación \(i\).
Mínimos Cuadrados Ordinarios
Definiciones:
-
\(\hat{\beta}_0\): estimador de \(\beta_0\)
-
\(\hat{\beta}_1\): estimador de \(\beta_1\)
-
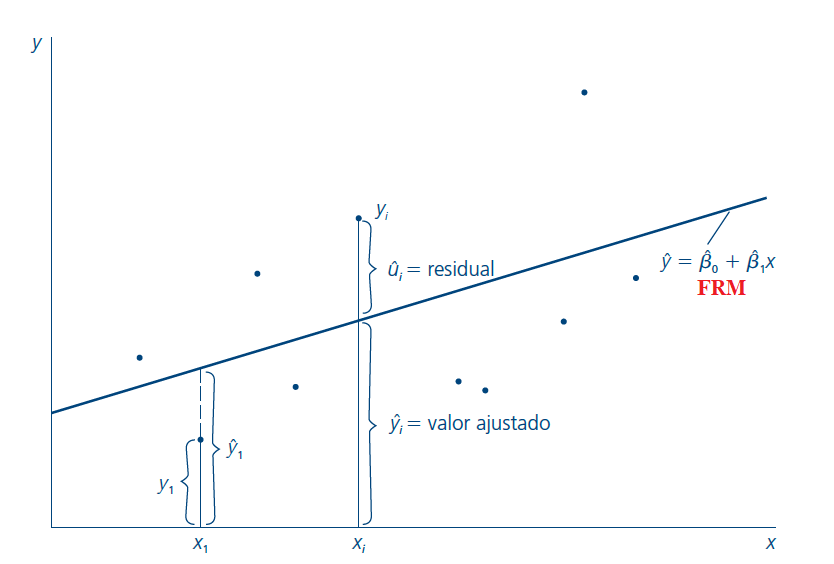
\(\hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1 x_i\): valor predicho/estimado de \(y_i\)
-
\(\hat{u}_i = y_i - \hat{y}_i\) residuo. El residuo es el análogo muestral del error.
-
Objetivo: encontrar los estimadores \(\hat{\beta}\) más parecidos a los parámetros \(\beta\), los \(\hat{y}_i\) más parecidos a \(y_i\), los \(\hat{u}_i\) más cercanos a 0.
-
MCO (Mínimos Cuadrados Ordinarios): encuentra los \(\beta\)'s que minimizan la suma de los residuos al cuadrado:
\[ \min_{\hat{\beta}_0, \hat{\beta}_1} \sum_{i=1}^{n} \hat{u}_i^2 = \min_{\hat{\beta}_0, \hat{\beta}_1} \sum_{i=1}^{n} (y_i - \hat{\beta}_0 - \hat{\beta}_1 x_i)^2 \]
Estimación de \(\beta\) MCO
Condiciones de primer orden:
Noten que todas estas variables están en la data. Entonces podemos obtener estos estimadores.
Tarea
-
Muestre que:
\(\sum_{i}^n(x_i - \bar{x})(y_i - \bar{y}) = \sum_{i}^n(x_i - \bar{x})y_i= \sum_{i}^n(y_i - \bar{y})x_i\).
Complemento · Pista para la tarea
Desarrolla el producto y usa que \(\sum_{i=1}^n (x_i - \bar{x}) = 0\) y \(\sum_{i=1}^n (y_i - \bar{y}) = 0\).
✍️ Practica · Tema 3
¿Qué minimiza MCO?
✅ Lámina 13. Juégalo en el simulador de cuadrados.
β̂₁ = Σ(xᵢ − x̄)(yᵢ − ȳ) / Σ(xᵢ − x̄)². ¿Qué pasa si todas las x son iguales?
✅ Por eso se necesita variación en x (supuesto RLS 3).
🧪 Practica en R · MCO a mano
Calcula β̂₀ y β̂₁ con las fórmulas de la lámina 14, compáralos con lm() y comprueba que ninguna otra recta tiene menor suma de residuos al cuadrado.
set.seed(3)
x <- runif(50, 8, 20)
y <- 0.1 + 0.55 * x + rnorm(50, sd = 3)

b1 <- sum((x - mean(x)) * (y - mean(y))) / sum((x - mean(x))^2)
b0 <- mean(y) - b1 * mean(x)
c(b0 = b0, b1 = b1)
coef(lm(y ~ x))                        # lo mismo

# MCO = la recta con la menor suma de residuos al cuadrado
ssr <- function(b) sum((y - b[1] - b[2] * x)^2)
optim(c(0, 0), ssr)$par                # búsqueda numérica del mínimo
c(MCO = ssr(c(b0, b1)), otra_recta = ssr(c(b0, b1 + 0.1)))
🎯 Reto: prueba otra recta en la última línea, por ejemplo c(b0 + 1, b1). ¿Su SSR es mayor o menor?
La regresión muestral y sus propiedades
Una vez estimada la recta, ¿qué propiedades cumple siempre?
Regresión Muestral (FRM)
-
Una vez que estimamos \(\hat{\beta}_0\) y \(\hat{\beta}_1\), obtenemos la función de regresión muestral (FRM):
\[ \hat{y} = \hat{\beta}_0 + \hat{\beta}_1 x \] -
La FRM que se obtiene de una muestra es la versión estimada de la función de regresión poblacional (FRP).
-
En general, la FRP es desconocida y uno se basa en una muestra para estimarla.
-
Valor ajustado o predicho: \(\hat{y}\).
Mínimos Cuadrados Ordinarios
Un ejemplo: relación entre educación y sueldos
-
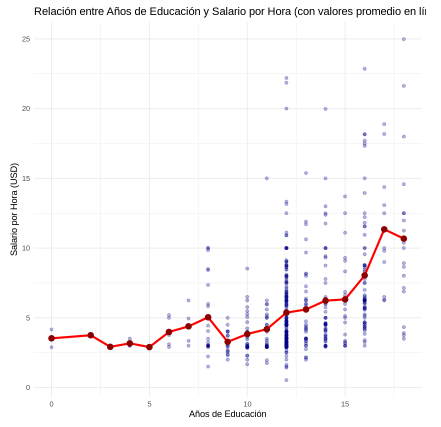
Tomamos la relación entre años de educación y sueldos por hora en EE. UU.
\[ salario_i = \beta_0 + \beta_1 \text{educación}_i + \epsilon_i \]
Un ejemplo
-
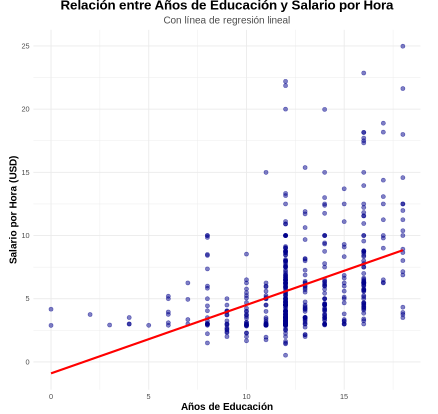
Años de educación y salarios por hora en Estados Unidos.
\[ \text {MCO: } \hat{\text{salario}} = 0.095 + 0.54 \text{educación} \] -
La línea de regresión minimiza los residuos al cuadrado.
Propiedades aritméticas de MCO
-
Los residuales suman cero:
\[ \sum_{i} \hat{u}_i = 0 \quad \Rightarrow \quad \bar{\hat{u}} = 0 \] -
\(x\) es ortogonal a los residuos:
\[ \sum_{i} x_{i} \hat{u}_i = 0 \] -
El promedio muestral de la variable dependiente \(y_i\) es igual al promedio muestral de la estimación \(\hat{y}_i: \bar{y} = \bar{\hat{y}}\)
-
La línea de regresión pasa por el promedio de los datos:
\[ \bar{y} = \hat{\beta}_0 + \hat{\beta}_1 \bar{x} \]
Complemento · Compruébalo
En el simulador encuentra la recta de mínimos cuadrados (más arriba, junto a la lámina 14) activa Mostrar recta MCO: verás que \(\sum_i \hat{u}_i = 0\), \(\sum_i x_i\hat{u}_i = 0\) y que la recta pasa por \((\bar{x}, \bar{y})\), incluso si arrastras los puntos.
✍️ Practica · Tema 4
Con salario estimado = 0.095 + 0.54·educación, ¿cuál es el salario predicho para 12 años de educación?
✅ 0.095 + 0.54 · 12 = 6.575. Pruébalo en el simulador de predicción.
¿Cuál de estas afirmaciones NO se cumple siempre en MCO con intercepto?
✅ Las propiedades de la lámina 20 son algebraicas; cada residuo puede ser grande.
🧪 Practica en R · Las propiedades, número a número
Estima una regresión y verifica las cuatro propiedades aritméticas de la lámina 20. Después predice el salario para 12 años de educación.
set.seed(4)
educacion <- sample(8:20, 200, replace = TRUE)
salario   <- 0.1 + 0.55 * educacion + rnorm(200, sd = 3)
m     <- lm(salario ~ educacion)
u_hat <- resid(m)
y_hat <- fitted(m)

# Propiedades aritméticas (lámina 20)
round(c(suma_residuos = sum(u_hat),
        suma_x_por_residuo = sum(educacion * u_hat),
        media_y = mean(salario), media_y_hat = mean(y_hat)), 6)
round(unname(coef(m)[1] + coef(m)[2] * mean(educacion) - mean(salario)), 10)  # = 0

# Predicción para 12 años con la recta de la lámina 19 y con la nuestra
0.095 + 0.54 * 12
predict(m, newdata = data.frame(educacion = 12))
🎯 Reto: predice el salario para 16 años de educación con predict().
Método de momentos
¿Hay otra forma de llegar a los mismos estimadores?
Método de momentos
Se eligen estimaciones de los parámetros \(\beta_0\) y \(\beta_1\) que resuelvan las contrapartes muestrales.
Estimación de \(\beta\) MCO
Condiciones de primer orden:
✍️ Practica · Tema 5
El método de momentos reemplaza E[u] = 0 y E[xu] = 0 por…
✅ Láminas 21–22.
En la regresión simple, ¿qué relación hay entre los estimadores de momentos y los de MCO?
✅ Lámina 23: las condiciones de primer orden de MCO son las mismas ecuaciones.
🧪 Practica en R · Resolver los momentos
Escribe las dos condiciones de momentos como un sistema lineal, resuélvelo con solve() y compara con MCO.
set.seed(5)
x <- runif(80, 8, 20)
y <- 0.1 + 0.55 * x + rnorm(80, sd = 3)

# Análogos muestrales: (1/n) Σ u = 0 y (1/n) Σ x u = 0, con u = y − b0 − b1 x
# Es un sistema lineal en (b0, b1):  A b = c
A <- rbind(c(1,       mean(x)),
           c(mean(x), mean(x^2)))
c_vec <- c(mean(y), mean(x * y))
solve(A, c_vec)          # estimadores de momentos
coef(lm(y ~ x))          # = MCO
🎯 Reto: cambia el tamaño de la muestra de 80 a 8 (en las dos líneas). ¿Siguen coincidiendo?
Bondad de ajuste y unidades de medida
¿Qué tan bien explica x la variación de y?
Descomposición de la varianza muestral
-
Sea SST la suma de cuadrados totales (total sum of squares):
\[ SST = \sum_{i=1}^{n} (y_i - \bar{y})^2 \] -
Sea SSE la suma de cuadrados explicados (explained sum of squares):
\[ SSE = \sum_{i=1}^{n} (\hat{y}_i - \bar{y})^2 \] -
Sea SSR la suma de cuadrados no explicados (residual sum of squares):
\[ SSR = \sum_{i=1}^{n} \hat{u}_i^2 \]
Se puede demostrar que:
Bondad de Ajuste: \(R^2\)
-
A partir de esta relación se define:
\[ R^2 = \frac{SSE}{SST} = 1 - \frac{SSR}{SST} \] -
Bondad de ajuste: la proporción de la varianza muestral de \(y\) que es explicada por \(x\).
-
Como \(0 \leq SSE \leq SST\), entonces \(0 \leq R^2 \leq 1\).
-
Cuanto más cercano a \(1\), más de la variabilidad de \(y\) es explicada por el modelo.
Cambio de unidades de medición
-
Si la variable independiente se divide o se multiplica por una constante distinta de cero, c, entonces el coeficiente de la pendiente de MCO se multiplica por c o se divide entre c, respectivamente.
-
Cambiar sólo las unidades de medición de la variable independiente no afecta el intercepto.
-
La bondad de ajuste del modelo no depende de las unidades de medición de las variables.
✍️ Practica · Tema 6
Si R² = 0.30, ¿qué significa?
✅ Lámina 25: R² = SSE/SST.
Si la variable x pasa de pesos a miles de pesos (se divide por 1 000), ¿qué pasa?
✅ Lámina 26. Pruébalo en el simulador de unidades.
🧪 Practica en R · SST = SSE + SSR
Verifica la descomposición de la varianza, calcula el R² a mano y cambia las unidades de x.
set.seed(6)
ingreso <- runif(150, 300000, 2000000)          # en pesos
gasto   <- 50000 + 0.6 * ingreso + rnorm(150, sd = 150000)
m <- lm(gasto ~ ingreso)

SST <- sum((gasto - mean(gasto))^2)
SSE <- sum((fitted(m) - mean(gasto))^2)
SSR <- sum(resid(m)^2)
c(SST = SST, SSE_mas_SSR = SSE + SSR)           # iguales
c(R2_a_mano = SSE / SST, R2_lm = summary(m)$r.squared)

# Cambio de unidades: ingreso en miles de pesos
ingreso_miles <- ingreso / 1000
m2 <- lm(gasto ~ ingreso_miles)
rbind(pesos = coef(m), miles = coef(m2))  # pendiente × 1 000
summary(m2)$r.squared                     # el R² no cambia
🎯 Reto: en vez de dividir el ingreso, divide el gasto por 1 000. ¿Qué coeficientes cambian?
Supuestos, insesgamiento y varianza
¿Cuándo podemos confiar en que MCO acierta en promedio, y con cuánta precisión?
Supuesto 1 RLS
En el modelo poblacional, la variable dependiente, y, está relacionada con la variable independiente, x, y con el error (o perturbación), u, de la manera siguiente:
donde \(\beta_0\) y \(\beta_1\) representan los parámetros poblacionales, del intercepto y pendiente, respectivamente. \(u\) contiene los efectos no observables que afectan a \(y\), \(u\) no debe confundirse con los residuales.
Supuesto 2 RLS
Se cuenta con una muestra aleatoria de tamaño n, \(\lbrace(x_i,y_i): i = 1, 2, ..., n\rbrace\).
Supuesto 3 RLS
No todos los valores muestrales de x, a saber \(\lbrace x_i, i = 1,.., n\rbrace\), son iguales, es decir, no todos tienen el mismo valor.
Supuesto 4 RLS
Para todo valor de la variable explicativa, el valor esperado del error u es cero.
\(E(u|x) = 0\).
Insesgamiento de los estimadores de MCO
Si se cumplen los supuestos 1-4 RLS, los estimadores \(\hat{\beta_0}\) y \(\hat{\beta_1}\) son insesgados:
El insesgamiento es una propiedad de las distribuciones muestrales de \(\hat{\beta_0}\) y \(\hat{\beta_1}\). No dice nada acerca de las estimaciones que se obtienen a partir de una determinada muestra. Se espera que, si la muestra es de alguna manera "representativa", la estimación estará "cerca" del valor poblacional.
-
Si u contiene factores que afectan a y que están correlacionados con x, puede obtenerse una correlación espuria.
-
Es decir, se encuentra una relación entre x e y que en realidad se debe a factores no observados que afectan a y que resultan estar correlacionados con x.
Supuesto 5 RLS
El error u tiene la misma varianza para cualquier valor de la variable explicativa.
La varianza de los factores inobservables, u, condicionales en x, es constante. Esto se conoce como el supuesto de homocedasticidad o de varianza constante.
Varianza de los estimadores de mínimos cuadrados ordinarios
Considerando el supuesto 5 RLS, tenemos:
✍️ Practica · Tema 7
¿Qué supuesto exige que no todos los valores muestrales de x sean iguales?
✅ Lámina 29: sin variación en x no se puede calcular β̂₁.
Que β̂₁ sea insesgado significa que…
✅ Láminas 31–32: con RLS 1–4, E[β̂₁] = β₁.
🧪 Practica en R · Insesgamiento y varianza por simulación
Repite 5 000 veces la muestra: el promedio de β̂₁ debería ser el β₁ verdadero, y su varianza, la de la fórmula de la lámina 34.
set.seed(7)
n <- 50
sigma <- 3
x <- runif(n, 8, 20)                    # x fija entre muestras
b1 <- replicate(5000, {
  y <- 0.1 + 0.55 * x + rnorm(n, sd = sigma)
  coef(lm(y ~ x))[2]
})
mean(b1)                                # ≈ 0.55: insesgado
c(var_simulada = var(b1),
  var_formula = sigma^2 / sum((x - mean(x))^2))

hist(b1, breaks = 40, main = "5 000 estimaciones de beta1",
     xlab = "beta1 gorro")
abline(v = 0.55, lwd = 2)
🎯 Reto: cambia sd = sigma por sd = 0.3 * x (el error crece con x). ¿Sigue siendo insesgado? ¿Coincide la fórmula?
🧠 Ideas clave
- En \(y = \beta_0 + \beta_1 x + u\), \(\beta_1\) es el cambio en \(E[y \mid x]\) por unidad de \(x\); es causal solo si \(E[u \mid x] = 0\).
- MCO elige la recta que minimiza \(\sum_i \hat{u}_i^2\); por eso \(\sum_i \hat{u}_i = 0\) y \(\sum_i x_i \hat{u}_i = 0\).
- \(SST = SSE + SSR\) y \(R^2 = SSE/SST\) mide ajuste, no causalidad: un \(R^2\) bajo no invalida la regresión.
- Con RLS 1–4 MCO es insesgado; con RLS 5 (homocedasticidad) vale \(\text{Var}(\hat{\beta}_1 \mid x) = \sigma^2 / \sum_i (x_i - \bar{x})^2\).
✅ Autoevaluación
Con los datos de EE. UU. se estimó: salario estimado = 0.095 + 0.54·educación. ¿Cuál es la interpretación correcta de 0.54?
✅ β̂₁ describe cómo cambia el salario esperado. Solo es causal si E[u|x] = 0 (supuesto 4), lo que es dudoso: ¿qué hay en u? La tercera opción describe un R², no una pendiente.
En una regresión, SST = 400 y SSR = 300. ¿Cuánto vale el R²?
✅ R² = 1 − SSR/SST = 1 − 300/400 = 0.25 (y SSE = SST − SSR = 100).
Según Var(β̂₁|x) = σ² / Σ(xᵢ − x̄)², ¿cuál de estos cambios no reduce la varianza de β̂₁?
✅ Un σ² mayor aumenta la varianza. Más observaciones y más dispersión en x aumentan Σ(xᵢ − x̄)² y la reducen (pruébalo en el simulador de insesgamiento).
📚 Para la próxima clase
- Wooldridge, capítulo 2 (El modelo de regresión simple).
- Próxima clase: Causalidad y variable omitida — ¿cuándo podemos interpretar \(\hat{\beta}_1\) como un efecto causal?